Tokens qui explosent ? Le guide d’économie par assemblage du contexte
Crédits qui fondent ? Explosion des tokens : 3 étapes (estimation, « nom seul », plans à la demande), 3 dosages et protection anti-dépassement.
Dans cet article 10 sections
Vous demandez simplement à l’IA de poursuivre un passage de deux mille signes, et pourtant vos crédits ont fondu d’un bon morceau. Le problème n’est souvent pas la « sortie », mais l’« entrée » — avant chaque écriture, le système donne par défaut à l’IA toute l’architecture du livre, la bible, les personnages, les suspenses ; ce coût de « lecture de la documentation » est le vrai coupable de l’explosion des tokens.
La bonne nouvelle : cette part est entièrement maîtrisable. Le « chargement intelligent du contexte » de Maliang Writer vous laisse décider vous-même de la quantité de documentation donnée à l’IA à chaque fois. Cet article vous apprend en trois étapes à dépenser vos crédits là où cela compte.
Points essentiels
- L’explosion des tokens vient surtout de l’« entrée » — l’assemblage complet par défaut de la documentation du roman, et non de la sortie de l’IA.
- Chargement intelligent du contexte = « assemblage à la demande » selon la situation, plutôt que « remplissage intégral » à chaque fois.
- Avant l’envoi, Maliang Writer estime en temps réel les tokens de cet assemblage et les compare à la limite par défaut de 60 000 ; le rouge sert d’alerte.
- Trois leviers pour économiser : passer de « complet » à « nom seul », ouvrir les plans de chapitre et de tome à la demande, désactiver les dimensions inutiles.
Pourquoi les tokens explosent-ils ?
Parce que la facturation d’un grand modèle porte sur le total « entrée + sortie », et la documentation du roman en entrée occupe souvent bien plus de place que les quelques milliers de signes que vous écrivez. La bible, les personnages, les suspenses et l’architecture d’un livre entier, cumulés, représentent facilement plusieurs dizaines de milliers de tokens, consommés de nouveau à chaque chapitre écrit.
Beaucoup de gens économisent en surveillant « combien de signes l’IA a écrits » : mauvaise direction. Le gros poste, c’est « combien de documentation l’IA lit à chaque fois ». Plus vous donnez, moins l’IA dévie, mais plus chaque génération coûte — c’est une balance que vous devez arbitrer activement.
Observation mesurée : dans nos tests internes, passer la bible et les personnages de « complet » à « nom seul » fait généralement baisser nettement les tokens de contexte par écriture, avec presque aucun effet perceptible sur la qualité des chapitres ordinaires. La clé pour économiser est de distinguer « quelles ressources l’IA utilise réellement maintenant ».
Pour comprendre la structure globale des coûts de l’écriture IA, voir Maliang Writer : version gratuite et version payante.
Qu’est-ce que le « chargement intelligent du contexte » ?
Le chargement intelligent du contexte consiste à vous remettre l’interrupteur du « combien de documentation donner à l’IA » : on dose selon la situation, au lieu de tout activer sans réfléchir à chaque fois. Son contraire est le « remplissage intégral » — quoi qu’on écrive, on envoie d’un bloc toute la documentation du livre.
L’idée centrale est simple : pour écrire des chapitres ordinaires, il suffit que l’IA sache « quels personnages et quels éléments de bible existent », elle demandera les détails à la demande ; ce n’est que pour les tournants clés qu’il faut la documentation complète en filet de sécurité. Le chargement intelligent vous permet de donner, selon la situation, juste la quantité d’information suffisante.
Point de vue exclusif : économiser des tokens ne signifie pas « donner moins de documentation et rendre l’IA bête ». C’est même l’inverse — quand on en donne trop, l’information clé est noyée et l’IA ne saisit plus l’essentiel. Donner « à la demande », avec précision, économise et donne souvent un texte plus concentré.
L’entrée se trouve dans la barre de l’assistant IA : cliquez sur l’engrenage « Gestion des fonctions IA », passez à l’onglet « Contexte ». Pour l’explication complète, voir le tutoriel d’assemblage du contexte.
Étape 1 : comprendre l’estimation des tokens en temps réel
Pour économiser, il faut d’abord pouvoir « voir » la dépense. Maliang Writer estime en temps réel, avant l’envoi, combien de tokens cet assemblage va coûter à peu près. Inutile d’attendre que les crédits soient déduits pour le regretter.
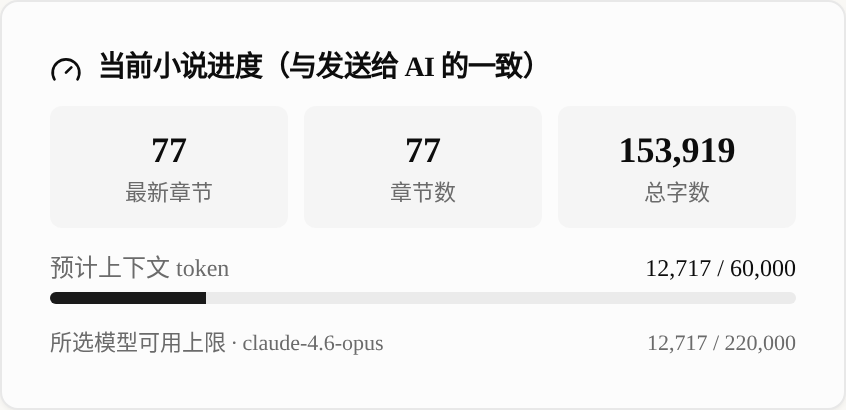
En haut du panneau, une barre de progression « tokens de contexte estimés » est suivie de la limite par défaut de 60 000. Elle calcule en direct le coût de l’assemblage actuel ; si elle vire au rouge, il faut alléger. Plus bas, une ligne « limite disponible du modèle choisi » affiche le nom du modèle de génération actuellement sélectionné — certains modèles ont une petite fenêtre, et vous êtes prévenu d’avance que « celui-ci ne peut pas contenir cet assemblage ».
Un petit moyen mnémotechnique : la barre du haut compare à la « limite par défaut de la plateforme », la ligne du bas compare à « ce que le modèle que vous avez choisi peut contenir ». Si aucune des deux ne vire au rouge, envoyez sans crainte.
Étape 2 : remplacer « complet » par « nom seul »
C’est le levier d’économie le plus immédiat. Faites défiler jusqu’aux « dimensions d’assemblage » : bible, personnages et suspenses ont chacun deux niveaux, « complet » et « nom seul ».
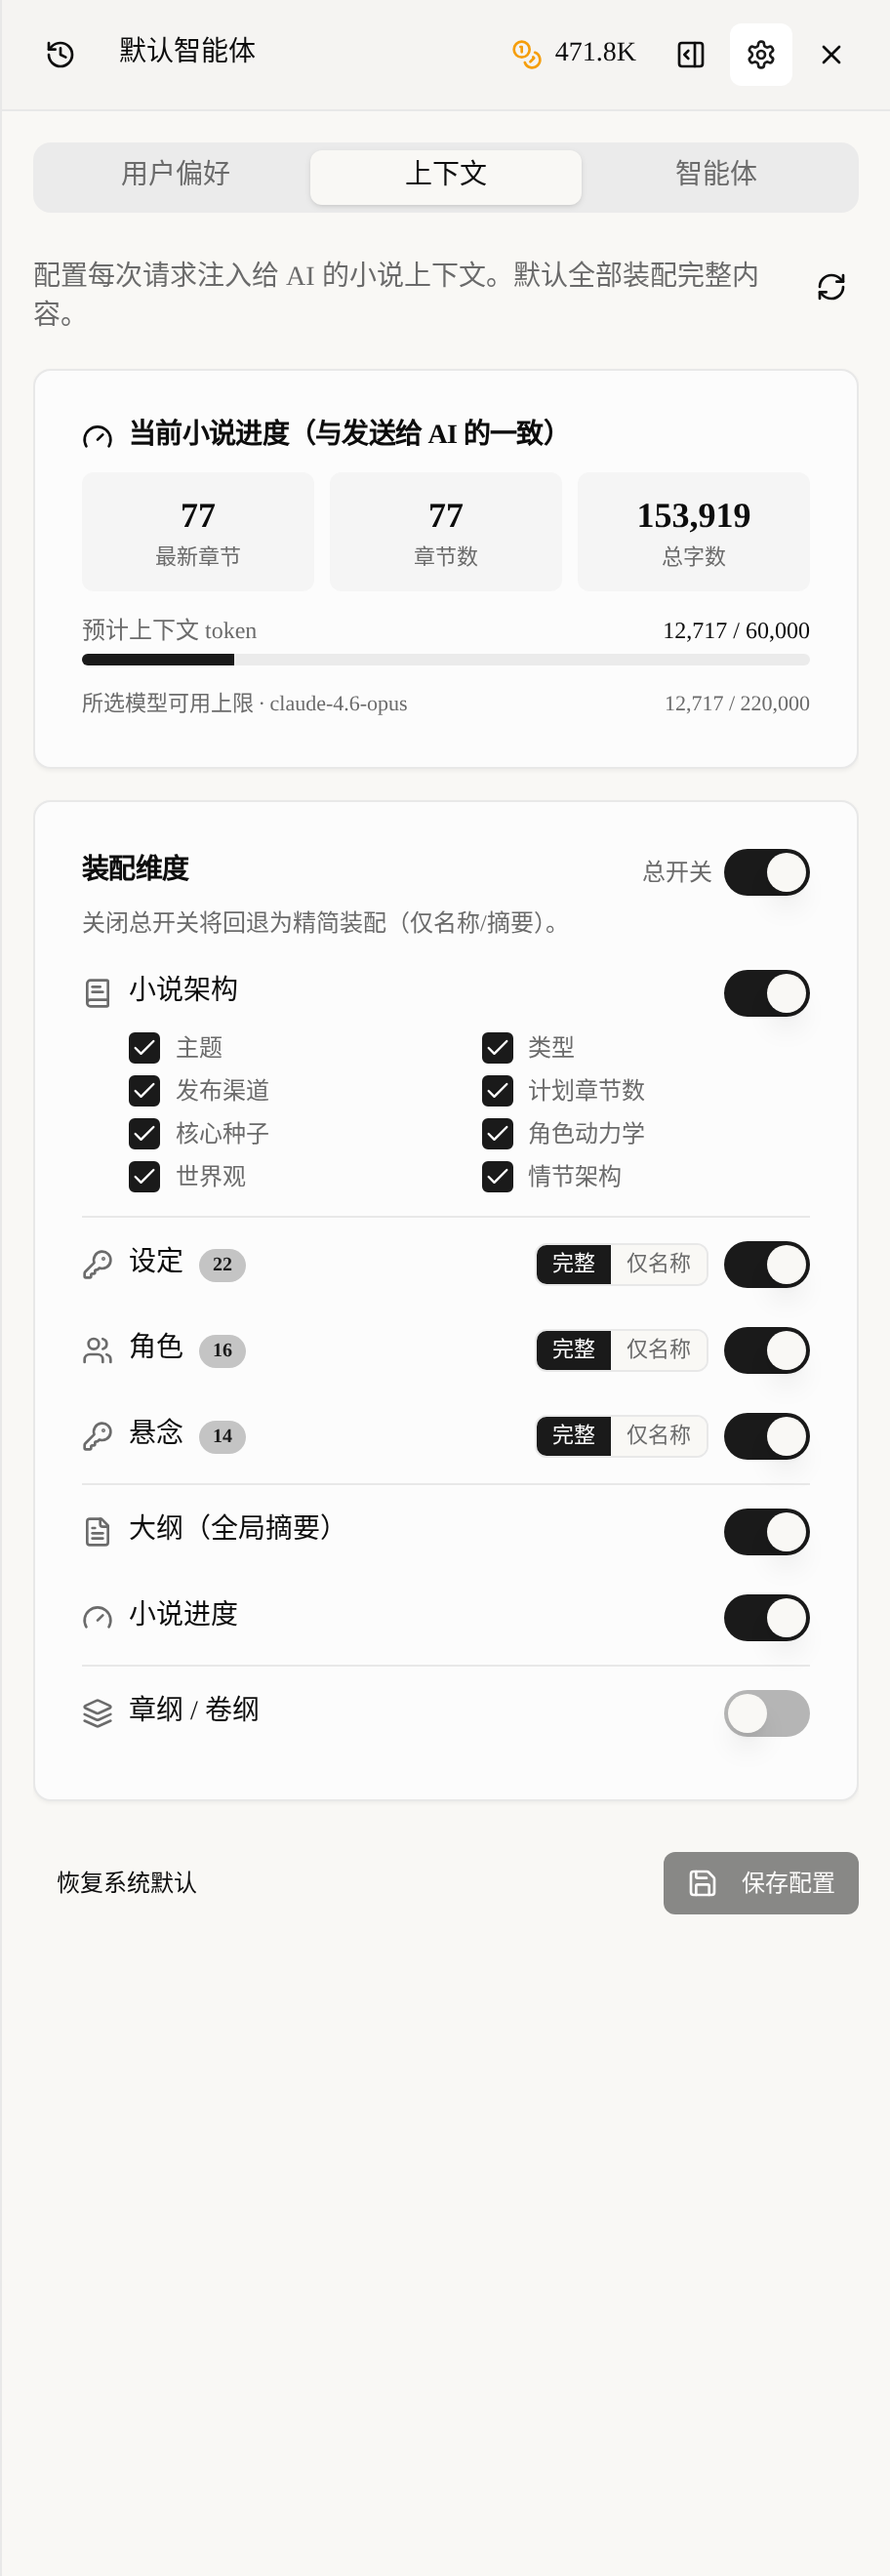
« Complet » donne à l’IA toute l’entrée, « nom seul » ne donne que la liste des noms, pour que l’IA sache que « ces éléments existent » sans détailler. Pour écrire en masse des chapitres ordinaires, avec bible et personnages en « nom seul », l’IA reconnaît toujours les personnages et ne dévie pas, et une bonne part des tokens est économisée.
Le petit nombre après chaque dimension (par exemple « Bible 22 », « Personnages 16 ») est le nombre actuel d’entrées du livre, pour vous aider à juger si « tout y mettre serait trop ». En haut à droite se trouve aussi un « interrupteur général » : le désactiver revient à l’« assemblage allégé », le plus économe, très adapté à une simple discussion créative.
Étape 3 : plans de chapitre et de tome à la demande, ne pas tout assembler par défaut
Les plans de chapitre et de tome sont de gros consommateurs de tokens : désactivés par défaut, ils permettent à l’IA de suivre strictement le plan une fois activés, mais le coût grimpe nettement. Ils s’ouvrent donc « à la demande », pas « en permanence ».
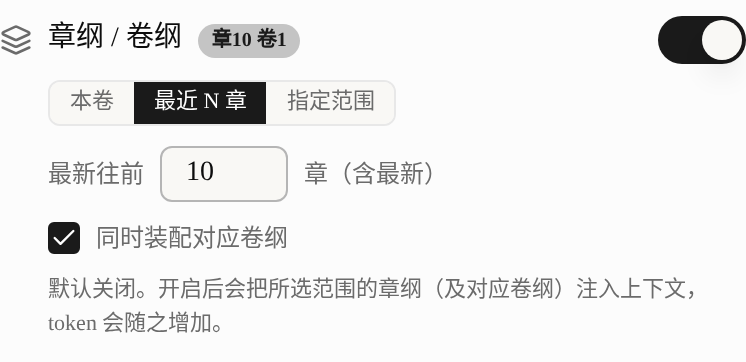
Trois portées d’assemblage : « Tome en cours » ne donne que les plans de chapitre du tome actuel, « N derniers chapitres » compte N chapitres en remontant depuis le plus récent, « Plage précise » vous laisse saisir à la main un intervalle de chapitres. Plus bas, une case « assembler aussi le plan de tome correspondant ». Le petit badge à côté de l’interrupteur indique combien de plans de chapitre et de tome ont réellement été assemblés cette fois.
Rappel d’économie : pour développer un passage ou écrire des chapitres de transition, vous pouvez simplement désactiver les plans de chapitre et de tome ; ne les rouvrez que pour les chapitres clés où l’IA doit « suivre strictement le plan », en privilégiant « Tome en cours » ou « N derniers chapitres », sans assembler tout le livre à tout bout de champ.
Trois dosages pratiques pour économiser des tokens
Inutile de tout régler à chaque fois : appliquez simplement les trois combinaisons suivantes selon la situation. Ce sont nos trois niveaux les plus utilisés :
| Situation | Bible / personnages | Suspenses | Plans de chapitre et de tome | Usage |
|---|---|---|---|---|
| Écriture en masse (le plus économe) | Nom seul | Désactivés | Tome en cours | Chapitres ordinaires, chapitres de transition |
| Chapitres clés (pour la sûreté) | Complet | Complet | N derniers chapitres + plan de tome | Climax, tournants, révélations |
| Discussion créative pure (le plus léger) | Interrupteur général coupé | Désactivés | Désactivés | Brainstorming, inspiration par le dialogue |
Une fois les modifications faites, n’oubliez pas de cliquer sur « Enregistrer la configuration » en bas — la configuration est enregistrée séparément pour chaque roman : un réglage par livre, valable durablement.
Retour d’expérience exclusif : la plupart des chapitres sont en fait « ordinaires », et la part des chapitres forts qui ont vraiment besoin du « complet » n’est pas élevée. Réglez le dosage par défaut sur « le plus économe » et n’améliorez temporairement que pour écrire les chapitres clés : sur la durée, les crédits économisés sont considérables.
Que se passe-t-il en cas de dépassement ? Le mécanisme de protection
Si votre assemblage fait dépasser la limite par défaut aux tokens estimés, le système vous protège activement, au lieu de déduire discrètement. La barre de progression devient rouge, et un message vous invite à activer « Contexte maximal » dans les paramètres de chat.
Si vous n’activez pas « Contexte maximal », la partie excédentaire est compressée automatiquement et l’IA risque de « ne pas tout voir » — la qualité de l’écriture en pâtit alors. De même, si la « limite disponible du modèle choisi » est dépassée, la ligne du bas vire aussi au rouge.
Face au rouge, deux solutions : alléger les dimensions selon les dosages ci-dessus (le plus économe fait généralement redescendre aussitôt), ou changer pour un modèle à contexte plus grand. Pour choisir un modèle, voir le guide de sélection des modèles d’IA.
Quoi d’autre pour économiser ? Deux astuces avancées
Première astuce : alléger le contexte avec la visibilité. Réglez sur « Masqué à l’IA » ou « Ouvert progressivement par tome » les éléments de bible inutiles à court terme et les amorces pas encore arrivées au tome de révélation : ils n’entreront pas dans le contexte. Même si « bible complète » est activée, l’assemblage réel ne contient que « la part à donner pour l’instant », ce qui économise et évite les spoilers. Voir Divulgation progressive et visibilité de la bible.
Deuxième astuce : bien choisir son modèle. Pour une même tâche, le prix unitaire et la fenêtre de contexte varient beaucoup d’un modèle à l’autre. Un modèle au bon rapport qualité-prix pour les chapitres ordinaires, puis un modèle haut de gamme pour les chapitres clés : un assortiment plus économique.
Rappel pratique : économiser des tokens est un « combo » : l’assemblage intelligent réduit le volume d’entrée, la visibilité retranche les entrées qui ne doivent pas être données, le choix du modèle optimise le prix unitaire. Les trois cumulés sont plus efficaces que de comprimer un seul poste. Intégrez cela à votre cadre de création de roman long, et le coût d’un roman long devient vraiment maîtrisable.
Questions fréquentes
Q : Économiser des tokens rend-il l’écriture de l’IA moins bonne ?
Non, à condition de donner « à la demande » et non de « supprimer au hasard ». Pour les chapitres ordinaires, avec « nom seul », il suffit que l’IA sache quels personnages et quels éléments de bible existent, les détails sont appelés à la demande ; seuls les tournants clés ont besoin du « complet ». En donner trop noie l’essentiel, et un dosage précis donne souvent un texte plus concentré.
Q : La limite par défaut de 60 000 tokens est-elle modifiable ? Faut-il forcément activer « Contexte maximal » en cas de dépassement ?
60 000 est la limite par défaut de la plateforme. En cas de dépassement sans « Contexte maximal », la partie excédentaire est compressée automatiquement et l’IA risque de ne pas tout voir ; activé, l’assemblage remplit autant que possible selon la fenêtre du modèle choisi. Nous conseillons de d’abord ramener l’estimation sous la limite avec le dosage le plus économe, et de n’activer le grand contexte que si c’est vraiment nécessaire.
Q : Comment savoir combien de tokens cela a vraiment coûté ?
Regardez la barre de progression « tokens de contexte estimés » en haut du panneau : elle estime en temps réel avant l’envoi et la compare à la limite par défaut. La ligne « limite disponible du modèle choisi » en dessous vous dit aussi si le modèle actuel peut contenir l’assemblage. Si aucune des deux ne vire au rouge, envoyez sans crainte.
Q : Faut-il activer les plans de chapitre et de tome ?
À la demande. Ils permettent à l’IA de suivre strictement le plan, mais ils sont gros consommateurs de tokens. Pour développer un passage ou écrire des chapitres de transition, désactivez-les ; n’activez-les que pour les chapitres clés, en privilégiant « Tome en cours » ou « N derniers chapitres », sans assembler tout le livre.
Q : La configuration est-elle globale ou propre à chaque livre ?
Elle est enregistrée séparément pour chaque roman. Le dosage d’économie de tokens que vous réglez pour un livre ne vaut que pour ce livre, et il faut le reconfigurer pour un autre. Après modification, pensez à cliquer sur « Enregistrer la configuration », sinon la fois suivante, c’est de nouveau l’assemblage complet par défaut.
Pour finir
Dans l’écriture IA, l’essentiel des crédits est dépensé à « lire la documentation », et la maîtrise de la quantité lue est entre vos mains. Comprendre l’estimation des tokens, remplacer « complet » par « nom seul », ouvrir les plans de chapitre et de tome à la demande — ces trois étapes font baisser le coût d’un bon cran.
En y ajoutant l’allègement par la visibilité et le bon choix du modèle, économiser des tokens devient un combo réutilisable. Allez dès maintenant régler votre dosage par défaut selon votre rythme d’écriture avec le tutoriel d’assemblage du contexte, pour que chaque crédit soit dépensé là où il est vraiment nécessaire.