Modèle IA 2026 pour un roman : Claude, Gemini, GPT, DeepSeek ?
Selon genre et tâche : sources officielles, test sur le même sujet, grille réutilisable et coût avec relances et retouches manuelles.
Dans cet article 10 sections
Quel modèle d’IA pour écrire un roman ? Choisissez d’abord selon votre tâche
Pour le texte quotidien, choisissez le modèle que vous retouchez le moins et dont le coût total reste acceptable ; pour le suspense et les récits chorals, regardez d’abord la causalité, les profils de personnages et les limites de l’information ; pour continuer un roman long, testez-le sur vos propres éléments de bible et chapitres existants, sans prendre la fenêtre de contexte pour une garantie de mémoire. Claude, Gemini, GPT et DeepSeek peuvent tous être candidats, mais un nom de marque n’est pas une version précise, et la même version peut avoir des paramètres, des plafonds et des tarifs différents selon la plateforme.
Pour un premier choix, inutile d’essayer dix modèles à la fois. Retenez deux versions que vous pouvez utiliser normalement, faites-leur faire, à partir du même matériau d’histoire ci-dessous, un plan, des dialogues et une réécriture, puis comparez en masquant les noms. Quand les résultats se valent, préférez le plus stable et celui qui demande le moins de retouches, plutôt que de courir après un « meilleur style » sans échantillon à l’appui.
Portée des preuves de cette page : il s’agit d’un guide de choix et d’auto-test, pas d’un nouveau classement de modèles. Lors de la révision du 2026-09-06, les anciennes notes, l’estimation du coût pour un million de signes et des formulations comme « se souvient parfaitement des 100 premiers chapitres » n’avaient pas de preuves suffisantes que le lecteur puisse recalculer ; elles ne sont plus présentées comme des conclusions de classement. L’histoire et les exemples positifs et négatifs ci-dessous sont des matériaux pédagogiques construits pour illustrer la méthode de vérification, et non des sorties mesurées d’un modèle. Les liens officiels servent à vérifier les produits et les méthodes d’évaluation ; ils ne prouvent pas qu’un modèle écrit mieux la fiction.
D’abord réduire les candidats : à quelle étape bloquez-vous le plus souvent ?
| Tâche de création | Ce qu’il faut comparer d’abord | Signe d’un modèle inadapté | À comparer ensuite |
|---|---|---|---|
| Écrire du texte chaque jour | Passages réutilisables, répétitions, stabilité sur un même genre | Il faut réécrire le ton narratif à chaque chapitre, ou les coupures sont fréquentes | Facturation réelle, attente du premier paragraphe, temps de retouche |
| Dialogues et scènes sentimentales | Chaque personnage parle-t-il avec un motif et une voix distincts ? | Tout le monde parle sur le même ton et la narration explique les émotions | Rythme, sous-texte et vos préférences personnelles |
| Suspense, récits chorals et amorces | Qui sait quoi, ordre des preuves, chaînes causales | Révèle la vérité trop tôt ; des personnages utilisent des indices qu’ils n’ont pas encore obtenus | Naturel de l’expression, coût de retouche |
| Suite d’un roman long | Les éléments clés de la bible sont-ils bien utilisés au bon moment ? | Oublie les blessures, la propriété des objets, le temps ou les relations entre personnages | Coût d’entrée, préparation du contexte, temps de réponse |
| Plan et réécriture | Les suggestions sont-elles précises et conformes à l’objectif donné ? | Dit seulement « ajoutez du conflit » sans événement ni coût | Différences entre les propositions, faisabilité, coût |
Ce tableau donne un ordre de choix, pas un classement de marques. Un auteur de romance et un auteur de hard SF peuvent obtenir des résultats différents ; un même auteur peut aussi choisir des modèles différents pour la planification, le texte et la vérification, mais il doit alors surveiller la rupture de style narratif qu’entraîne un changement de modèle.
Claude, Gemini, GPT, DeepSeek : vérifiez d’abord la version, puis comparez
| Famille de modèles candidate | À vérifier avant usage | Points clés du test de roman | Sources officielles |
|---|---|---|---|
| Claude | Identifiant exact du modèle, réglage de réflexion, limites d’entrée et de sortie | Motif des dialogues, ton narratif, réécriture selon les retours | Catalogue des modèles, tarifs |
| Gemini | Version stable ou préversion, point d’accès réel, limites de contexte et de sortie | Citation de documents sur plusieurs chapitres, éléments de bible oubliés, tâches sur documents texte-image | Catalogue des modèles, tarifs |
| GPT | Version précise, réglage du raisonnement, produit de chat ou API | Causalité du plan, respect des contraintes, réécriture appuyée sur des preuves | Catalogue des modèles, tarifs |
| DeepSeek | Version réelle du modèle, mode de réflexion, cache et mode de facturation de la sortie | Expression sur les genres chinois, cohérence des personnages, volume de retouches du texte | Modèles et tarifs |
Les « points clés du test » sont les aspects que ce guide suggère de vérifier ; cela n’affirme pas que les autres modèles en sont incapables. Quand une plateforme n’affiche qu’un « modèle avancé » ou un « mode intelligent », notez le niveau visible, sans lui attribuer vous-même un identifiant de modèle sous-jacent.
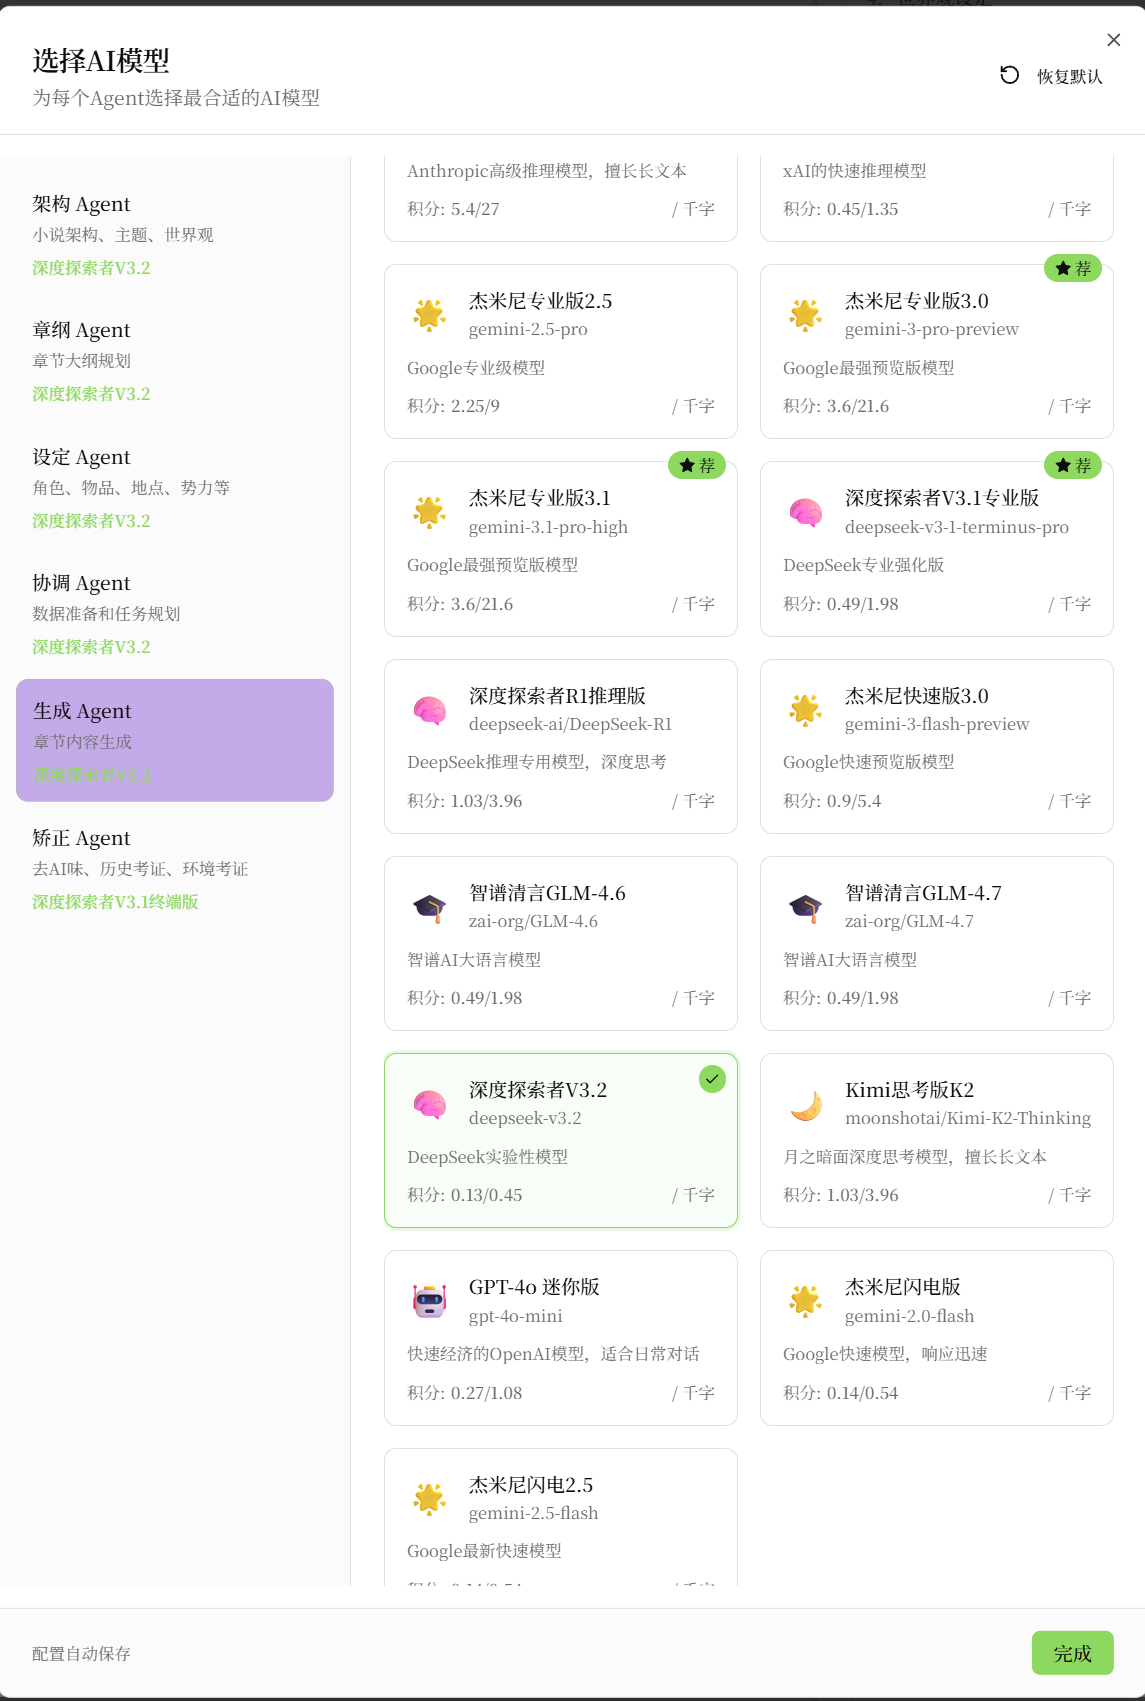
Le tarif affiché d’une API officielle n’est pas non plus le prix d’un abonnement à un produit de chat, et encore moins le prix en crédits de Maliang Writer. Pour savoir si une version est proposée sur le site, fiez-vous à l’écran de choix du modèle de la fonction concernée ; avoir écrit un article de présentation ne signifie pas que cette version est intégrée. Les prix et périodes de Maliang figurent dans Tarifs et abonnements, et l’entrée de la fonctionnalité se trouve dans le guide des réglages multi-modèles.
Test sur une même histoire : un même matériau, trois tâches
Télécharger le kit d’essai complet et la fiche d’enregistrement vierge. Le matériau provient de la même source d’énoncés que cette page ; le fichier ne contient aucun résultat prérempli et n’exige aucune inscription.
Voici le matériau d’exercice original de ce guide, utilisable pour un choix personnel. Vous pouvez aussi le remplacer par un court extrait d’une œuvre que vous avez le droit d’utiliser ; ne téléversez pas de manuscrits d’autrui sans autorisation ni de documents contenant des informations privées. Pour chaque candidat, utilisez exactement la même bible, la même tâche et la même consigne de longueur de sortie.
Bible fixe de l’histoire
Histoire : L’embarcadère sous la pluie

Personnages et faits :
1. Qi An est réparateur de parapluies ; il a le poignet droit blessé et ne peut pas porter de charge lourde de la main droite.
2. Lu Yao est le comptable de l’embarcadère : il se souvient des horaires des bateaux, mais ne sait pas lire.
3. Une lettre non ouverte est dans la poche intérieure du manteau de Qi An ; lui seul sait qu’elle s’y trouve.
4. La clé de bronze a déjà été remise au batelier et ne peut pas revenir dans les mains de Qi An sans explication.
5. Le dernier bac ne quitte la rive qu’après le troisième coup de la grande cloche.
6. Cette scène adopte uniquement le point de vue limité de Qi An ; on ne peut pas écrire directement les pensées de Lu Yao.

Objectif immédiat :
Qi An veut s’assurer, avant de quitter le quai, que Lu Yao ne ment pas, mais sans révéler l’existence de la lettre.
Lu Yao veut que Qi An reste, mais ne peut pas résoudre le conflit par une déclaration directe.

Direction de la fin :
La relation entre les deux change un peu et laisse un doute vérifiable au chapitre suivant,
sans révéler dans cette scène le contenu de la lettre.
Tâche 1 : le plan a-t-il une causalité, ou seulement six jolis titres ?
À partir de la bible fixe, écris six points d’intrigue consécutifs.
Pour chaque point, indique : qui agit, quel coût l’action lui impose, quel changement elle provoque.
Limite la longueur totale à 300–450 caractères chinois, espaces non comptés.
N’ajoute aucun personnage ni objet nouveau qui résoudrait directement le conflit.
Produis le plan, pas le texte.
Vérifiez que chaque tournant découle de l’étape précédente. Si, une fois les noms de personnages masqués, les six points conviennent à n’importe quelle histoire, c’est généralement que la proposition n’est pas encore assez concrète.
Tâche 2 : les dialogues montrent-ils les objectifs différents des deux personnages ?
À partir de la bible fixe, écris une scène de 500–700 caractères chinois, espaces non comptés.
Au moins quatre répliques alternées ; dialogue et actions entremêlés, sans étiquettes de personnage en liste.
Garde le point de vue limité de Qi An ; n’explique pas directement ce que pense Lu Yao.
Chacun essaie de faire changer la décision de l’autre ; ne conclus pas par une réconciliation directe.
Produis uniquement le texte.
Ne vous contentez pas de juger s’il y a « de belles formules ». Mieux vaut noter : quelle phrase sonde, quel geste esquive, et si la situation a changé après la réplique.
Tâche 3 : après des retours de modification, abîme-t-il ce qu’on ne lui a pas demandé de changer ?
Pour chaque modèle, utilisez sa propre sortie complète de la tâche 2, puis joignez la même demande de modification :
Conserve les faits existants, la propriété des objets, l’ordre chronologique et les relations entre personnages.
Supprime le résumé psychologique explicatif et fais porter le dernier doute par un geste observable.
Garde le point de vue d’origine, ne révèle pas la lettre, n’ajoute aucun personnage.
Produis la scène révisée complète, puis, à part, au plus trois notes de modification.
Cette étape évalue le flux de travail complet « du premier jet de chacun à sa version révisée », pas une comparaison de pure réécriture à entrée identique. Pour comparer à part la capacité de réécriture, choisissez un autre premier jet identique et figé, remis à tous les modèles ; ne mélangez pas les résultats des deux expériences dans une même moyenne.
Usage en petit échantillon : faites chaque tâche deux fois par modèle ; deux modèles produisent donc au total douze sorties. Utilisez à chaque passage une session neuve et propre ; la tâche 3 reprend le premier jet de la tâche 2 du même passage. Conservez tous les résultats, y compris les échecs, sans ne garder que le meilleur texte. Répéter le même énoncé n’équivaut pas à douze énoncés indépendants, et ne peut en aucun cas représenter tous les genres. Après ce premier tri, revérifiez avec plusieurs de vos propres chapitres, de types différents.
Comment juger : d’abord les contraintes dures, puis le style en aveugle
Notez d’abord si les six faits fixes ont été violés. Ne laissez pas de belles formulations masquer des problèmes localisables comme « poignet droit blessé mais il porte la caisse de la main droite » ou « ne sait pas lire mais lit directement la lettre ».
Les deux passages ci-dessous sont des exemples positif et négatif pédagogiques, construits pour illustrer la méthode de vérification, et non des scores de modèle :
Contre-exemple : Qi An soulève la caisse de bois de la main droite et claque la clé de bronze sur la table. Lu Yao lit les caractères de la lettre dans sa poche intérieure et comprend enfin la raison de sa venue.
Il viole à la fois la restriction de blessure, la propriété de la clé et la limite d’information, et présente comme sachant lire un personnage « qui ne sait pas lire ».
Exemple corrigé : Qi An repousse la caisse de bois contre son pied gauche, sans tendre la main. Lu Yao lui redemande l’horaire du bac, mais il regarde d’abord vers la tour de la cloche. Le troisième coup n’a pas encore sonné.
Le second passage montre seulement comment ne pas briser les faits connus ; il n’est pas forcément meilleur sur le plan littéraire. Le conflit est-il suffisant, la langue colle-t-elle au genre : c’est à vous d’en juger.
Remplacez les noms de modèles par A et B, lisez en alternance, et conservez pour chaque point des phrases précises comme justification :
| Point de contrôle | Méthode d’enregistrement |
|---|---|
| Faits et point de vue | Marquez chacun : réussi, échoué ou impossible à juger, avec la phrase d’origine |
| Causalité et gain d’information | Dites ce qui a changé ; un simple « fluide » ne suffit pas comme commentaire |
| Voix des personnages | Trouvez une phrase que seul ce personnage dirait ; si vous n’en trouvez pas, notez-le tel quel |
| Intégrité après révision | Comparez avec le premier jet et signalez les faits ajoutés, supprimés ou abîmés sans demande |
| Degré d’adoption | Indiquez les passages réellement conservés et le temps de retouche ; ne comptez pas la longueur de sortie comme volume adopté |
| Stabilité | Notez séparément les écarts entre les deux passages, coupures, refus de répondre et dépassements de délai ; une bonne performance isolée n’est pas une conclusion de stabilité |
Si l’évaluation en aveugle vous est peu familière, commencez par la méthode d’évaluation d’OpenAI : concevoir l’évaluation à partir de tâches réelles, éviter les simples impressions subjectives et vérifier l’évaluation elle-même. Cette référence méthodologique ne vaut pas aval d’OpenAI pour les résultats de choix de modèle de cette page.
Combien coûte l’écriture d’un roman ? Comptez « par millier de signes adoptés », pas seulement par génération
Enregistrez séparément au moins quatre éléments : le coût réel d’entrée, le coût de sortie, le coût des relances facturées et le temps de retouche humaine. Ne convertissez pas le nombre de caractères chinois en tokens selon un ratio fixe, et n’additionnez pas directement des devises différentes.
Coût du modèle par millier de signes adoptés
= coût réel total du modèle pour le même ensemble de tâches ÷ nombre de caractères chinois finalement adoptés × 1000

À noter aussi : minutes de retouche humaine, secondes d’attente du premier paragraphe, temps total d’achèvement.
Si le nombre de signes adoptés est 0, notez « aucune sortie exploitable », et non « coût nul ».
Simple exemple de calcul, ni devis ni mesure : si un premier jet et ses relances ont coûté 2 yuans au total et que 1 600 signes ont finalement été retenus, le coût du modèle est de 1,25 yuan par millier de signes adoptés. Si vous avez aussi retouché pendant une demi-heure, cette demi-heure doit entrer dans votre décision. Un appel unique moins cher ne correspond pas forcément à un chapitre exploitable moins cher.
Quand un développeur appelle lui-même l’API, il faut aussi distinguer, selon la facturation du service utilisé, les entrées servies depuis le cache, les entrées hors cache et les sorties ; les détails se trouvent dans les tarifs Claude, tarifs Gemini, tarifs GPT et tarifs DeepSeek. Ce guide ne convertit pas des tarifs de canal en garantie du type « un million de signes coûtent tant ».
Suite d’un roman long : grande fenêtre et mémoire fiable sont deux choses différentes
Une fois les scènes courtes réussies, revérifiez avec des chapitres existants. Placez les points de contrôle au début, au milieu et près du chapitre en cours, et vérifiez à chaque fois l’identité des personnages, les blessures, les objets, la chronologie et les informations non révélées ; faites réellement utiliser ces conditions par la suite, au lieu de seulement demander si le modèle sait les répéter.
Quand le matériau dépasse la limite d’entrée réelle, notez comment vous l’avez coupé, résumé ou sélectionné. Pour comparer des modèles, faites d’abord un test à entrée identique ; traitez ensuite la gestion du contexte proposée par chaque plateforme comme une autre expérience de flux de travail. On ne peut pas fournir un matériau complet d’un côté et seulement un résumé de l’autre, puis attribuer toute la différence au modèle lui-même.
L’étude « Lost in the Middle » examine comment les modèles de langage testés exploitent différemment l’information selon sa position dans un long contexte. Ce n’est pas un classement de tous les modèles de 2026, et elle ne remplace pas un nouveau test sur votre version actuelle. Pour la création, la démarche prudente consiste à conserver la fiche de bible, les événements récents et les limites d’information des personnages, et à revérifier après chaque changement de modèle.
Pour mettre en ordre un matériau de roman long, voyez aussi le cadre de création de romans longs et le tutoriel d’assemblage du contexte. Il s’agit ici de méthode d’usage : nul besoin de remanier tout votre système d’écriture pour choisir un modèle.
Comment démarrer dans Maliang, sans changer d’abord le modèle de tout le livre
Choisissez d’abord un chapitre existant représentatif, conservez le manuscrit original et la bible, puis ouvrez les réglages de modèle de la fonction actuelle pour confirmer les versions réellement disponibles. Ne comparez que sur ce passage ; une fois satisfait, décidez d’étendre ou non. Si vous utilisez des modèles différents selon les tâches d’écriture, conservez une voix de personnage, un point de vue et des exigences narratives uniformes.
Si vous n’avez pas encore de plan, utilisez d’abord les modèles de plan de roman pour clarifier l’objectif des personnages, les obstacles et l’évolution des chapitres ; si vous n’avez pas encore commencé le premier chapitre, enchaînez avec le parcours d’initiation à l’écriture d’un roman avec l’IA. Quand ces matériaux sont insuffisants, prendre directement un modèle plus cher ne résout pas forcément le problème. Pour comparer le ton des dialogues, voyez le guide du style personnel et de la voix des personnages ; pour traiter les lignes vides et la ponctuation issues d’un copier-coller, vous pouvez d’abord utiliser la mise en forme de texte gratuite, mais le résultat de la mise en forme ne peut pas tenir lieu de note de style.
Questions fréquentes
Quelle est la meilleure IA pour écrire un roman ?
Cette page n’a pas assez de preuves pour désigner un champion unique, tous genres et toutes versions confondus. Le meilleur candidat pour vous est celui qui, dans votre propre test sur une même histoire, conserve le plus de contenu exploitable, abîme le moins la bible et respecte votre budget et vos délais d’attente. Faites d’abord une petite comparaison, puis décidez du modèle principal.
Une fenêtre de contexte plus grande garantit-elle qu’un roman long n’aura pas d’incohérences ?
On ne peut rien garantir sur la seule foi des spécifications de fenêtre. La capacité d’entrée, l’intégralité des matériaux, la position de l’information et la bonne exploitation au moment de la génération se vérifient séparément. Testez avec des éléments de bible qui influencent l’intrigue en cours, et ne vous contentez pas de demander au modèle s’il « s’en souvient ».
Régler l’effort de réflexion au maximum rend-il forcément le texte meilleur ?
Cette page n’en fait pas la promesse. Fixez d’abord les paramètres pour établir une référence, puis modifiez séparément le réglage de réflexion et comparez la sortie réelle, l’attente et le coût. Ne changez pas en même temps le modèle, le prompt, le matériau et le réglage de raisonnement pour ensuite traiter le résultat comme une expérience à variable unique.
Ce guide garantit-il l’acceptation, la signature d’un contrat ou un résultat de détection ?
Non. La qualité d’un roman, les règles d’une plateforme et les résultats de détection sont des questions différentes ; un test de choix de modèle ne prouve pas non plus qu’un texte a été écrit par un humain. Avant de soumettre, consultez les règles officielles en vigueur de la plateforme visée.
Cette révision et ses sources
2026-09-06 : l’adresse de la page et la date de première publication sont conservées ; la page devient un guide de choix vérifiable, avec des énoncés de test originaux et des exemples pédagogiques positif et négatif, et les anciennes notes, les mémoires « absolues » et les conclusions de coût fixe pour un million de signes dépourvues de base de recalcul sont retirées. Aucun nouveau comparatif de modèles payants n’a été mené cette fois.
Les sources officielles servent respectivement à vérifier les modèles et les tarifs et comme référence de méthode d’évaluation ; la prise en charge réelle d’un produit dépend du service utilisé. Les histoires, tableaux et calculs de coût du texte sont des matériaux pédagogiques de ce guide. Si vous trouvez une erreur de fait précise, vous pouvez la signaler via le formulaire de retour sur le contenu en indiquant la page, la phrase d’origine et vos sources.