L’IA s’effondre sur un roman long ? Un cadre pour un million de signes
Incohérences à 300 000 signes ? 3 causes de l’effondrement de l’IA et un cadre en 5 étapes : plan en trois niveaux, contexte, visibilité, persona, graphe de connaissances.
Dans cet article 10 sections
Écrire un roman directement avec un grand modèle donne souvent des dix premiers chapitres éblouissants, puis, vers les 300 000 signes, tout « s’écroule » : l’épée du héros, encore utilisée au tome précédent, disparaît sans explication dans celui-ci ; un personnage secondaire change de prononciation de nom ; et les amorces pourtant bien posées, l’IA les emmène n’importe où à sa guise.
Le problème n’est pas que le modèle manque d’intelligence, mais que vous ne lui avez pas donné un cadre de création de roman long. Pour le court, on compte sur l’inspiration ; pour le long, sur l’ingénierie. Le cadre en cinq étapes ci-dessous a été affiné par l’équipe de Maliang Writer sur des romans longs d’un million de signes, avec un seul objectif : que l’IA, du chapitre 1 au chapitre 1000, « se souvienne, ne dévie pas et ne divulgâche pas ».
Points essentiels
- Trois causes de l’effondrement de l’IA sur un roman long : la fenêtre de contexte ne contient pas tout le livre, la mémoire n’a pas d’ancrage externe, le style n’est soumis à aucune contrainte unifiée.
- La solution consiste à décomposer la « création » en un chantier maîtrisable : le plan en trois niveaux pour l’ossature, l’assemblage du contexte pour le champ de vision, la visibilité pour les spoilers, les agents personnalisés pour l’unité de style, le graphe de connaissances pour la cohérence.
- Maliang Writer fixe par défaut la limite de contexte à 60 000 tokens, et concilie qualité et coût par un « assemblage à la demande » plutôt qu’un « remplissage intégral ».
- L’intérêt du cadre n’est pas de laisser l’IA écrire à votre place, mais de lui faire produire de façon stable dans le cadre de vos règles.
Pourquoi l’IA s’effondre-t-elle sur un roman long ?
En une phrase : le volume d’informations d’un roman long dépasse de loin ce que le modèle peut « voir » en une fois. Un roman d’un million de signes équivaut à environ 1,5 million de tokens, alors que la fenêtre de contexte des modèles courants n’est généralement que de quelques dizaines de milliers à quelques centaines de milliers de tokens : impossible d’y faire tenir le livre. Le modèle ne voit alors que les passages les plus récents, et l’« amnésie » est quasi inévitable.
L’effondrement vient généralement de trois endroits. Le premier est le débordement du contexte : à mesure que la documentation s’accumule, une fois la fenêtre dépassée, les anciennes informations sont discrètement tronquées. Le deuxième est le défaut d’ancrage de la mémoire : sans « cerveau externe » stable qui consigne l’état actuel des personnages, l’IA ne peut que deviner. Le troisième est la dérive de style : à chaque conversation, on re-précise le style, de manière incohérente, et le texte devient naturellement tantôt chaud, tantôt froid.
Observation mesurée : dans nos tests internes sur romans longs, sans aucune gestion du contexte, en comptant uniquement sur de « longues conversations » pour poursuivre l’écriture, les contradictions de réglages apparaissent généralement en nombre entre 200 000 et 400 000 signes ; avec le cadre structuré activé, sur la même longueur, les états de personnages ne se brouillent presque plus.
En confiant chacune de ces trois choses à un mécanisme dédié, l’effondrement se décompose en problèmes d’ingénierie qu’on peut résoudre un par un. Pour aller plus loin, voir les principes de collaboration de l’écriture multi-agents.
À quoi ressemble le cadre de création de roman long ?
Ce cadre se compose de quatre couches d’ossature + cinq actions. Les quatre couches : plan général (tout le livre) → plan de tome (chaque tome) → plan de chapitre (chaque chapitre) → texte ; les cinq actions sont des opérations concrètes autour de « quoi donner à l’IA, quoi lui cacher, sur quel ton écrire, sur quoi s’appuyer en dernier recours ».
Imaginez un plateau de tournage : le plan en trois niveaux est le scénario, l’assemblage du contexte est « quelles pages du scénario les acteurs voient pour la scène du jour », la visibilité est « quels extraits qui divulgâchent on ne leur montre pas encore », l’agent personnalisé est « le rôle et le style de jeu fixés pour l’acteur », et le graphe de connaissances est la scripte, qui s’assure que les faux raccords sont repérés.
Parcourons ces cinq étapes dans l’ordre. Chacune peut produire des effets seule, mais c’est en les empilant que l’effet devient multiplicatif.
Étape 1 : poser d’abord l’ossature du « plan en trois niveaux »
La condition pour qu’un roman long n’avorte pas, c’est d’avoir d’abord une colonne vertébrale qui traverse tout le livre. Le plan en trois niveaux gère par couches l’orientation macro et les intrigues micro : le plan général fixe le conflit central et l’arc de croissance du héros, le plan de tome planifie les objectifs d’étape de 30 000 à 50 000 signes par tome, le plan de chapitre détaille les points d’intrigue de chaque chapitre.
Rédigez d’abord le plan général, puis demandez à l’IA d’en déduire les plans de tome, et enfin tirez des plans de tome les plans de chapitre. Ainsi, lorsque l’IA génère le texte, elle a toujours une « contrainte supérieure » et ne s’écarte pas de la ligne principale en cours de route.
Rappel exclusif : ne générez pas d’un coup tous les plans de chapitre du livre. Un roman long « grandit en s’écrivant » ; verrouiller trop tôt les plans de chapitre suivants vous entravera quand l’intrigue pousse naturellement. Les plans de tome d’abord, les plans de chapitre générés au fil de l’eau : c’est le rythme le plus sûr.
Pour la marche à suivre, voir le tutoriel du système de plan en trois niveaux ; pour une méthodologie plus poussée, lisez Le plan en trois niveaux : finir enfin ses romans longs.
Étape 2 : maîtriser le « champ de vision » de l’IA avec l’assemblage du contexte
Une fois le plan établi, il faut décider de la quantité de documentation que l’IA « voit » à chaque écriture. Maliang Writer vous confie ce commutateur : dans la barre de l’assistant IA, cliquez sur l’engrenage « Gestion des fonctions IA », passez à l’onglet « Contexte », et vous contrôlez un par un si l’architecture du roman, la bible, les personnages, les éléments de suspense, le plan général, les plans de chapitre et de tome sont assemblés, et avec quel niveau de détail.
Cette étape détermine directement deux choses : la qualité et le coût. Plus vous donnez, moins l’IA dévie, mais plus elle consomme de tokens (crédits). L’approche intelligente est de doser selon la situation, et non de tout activer à chaque fois.
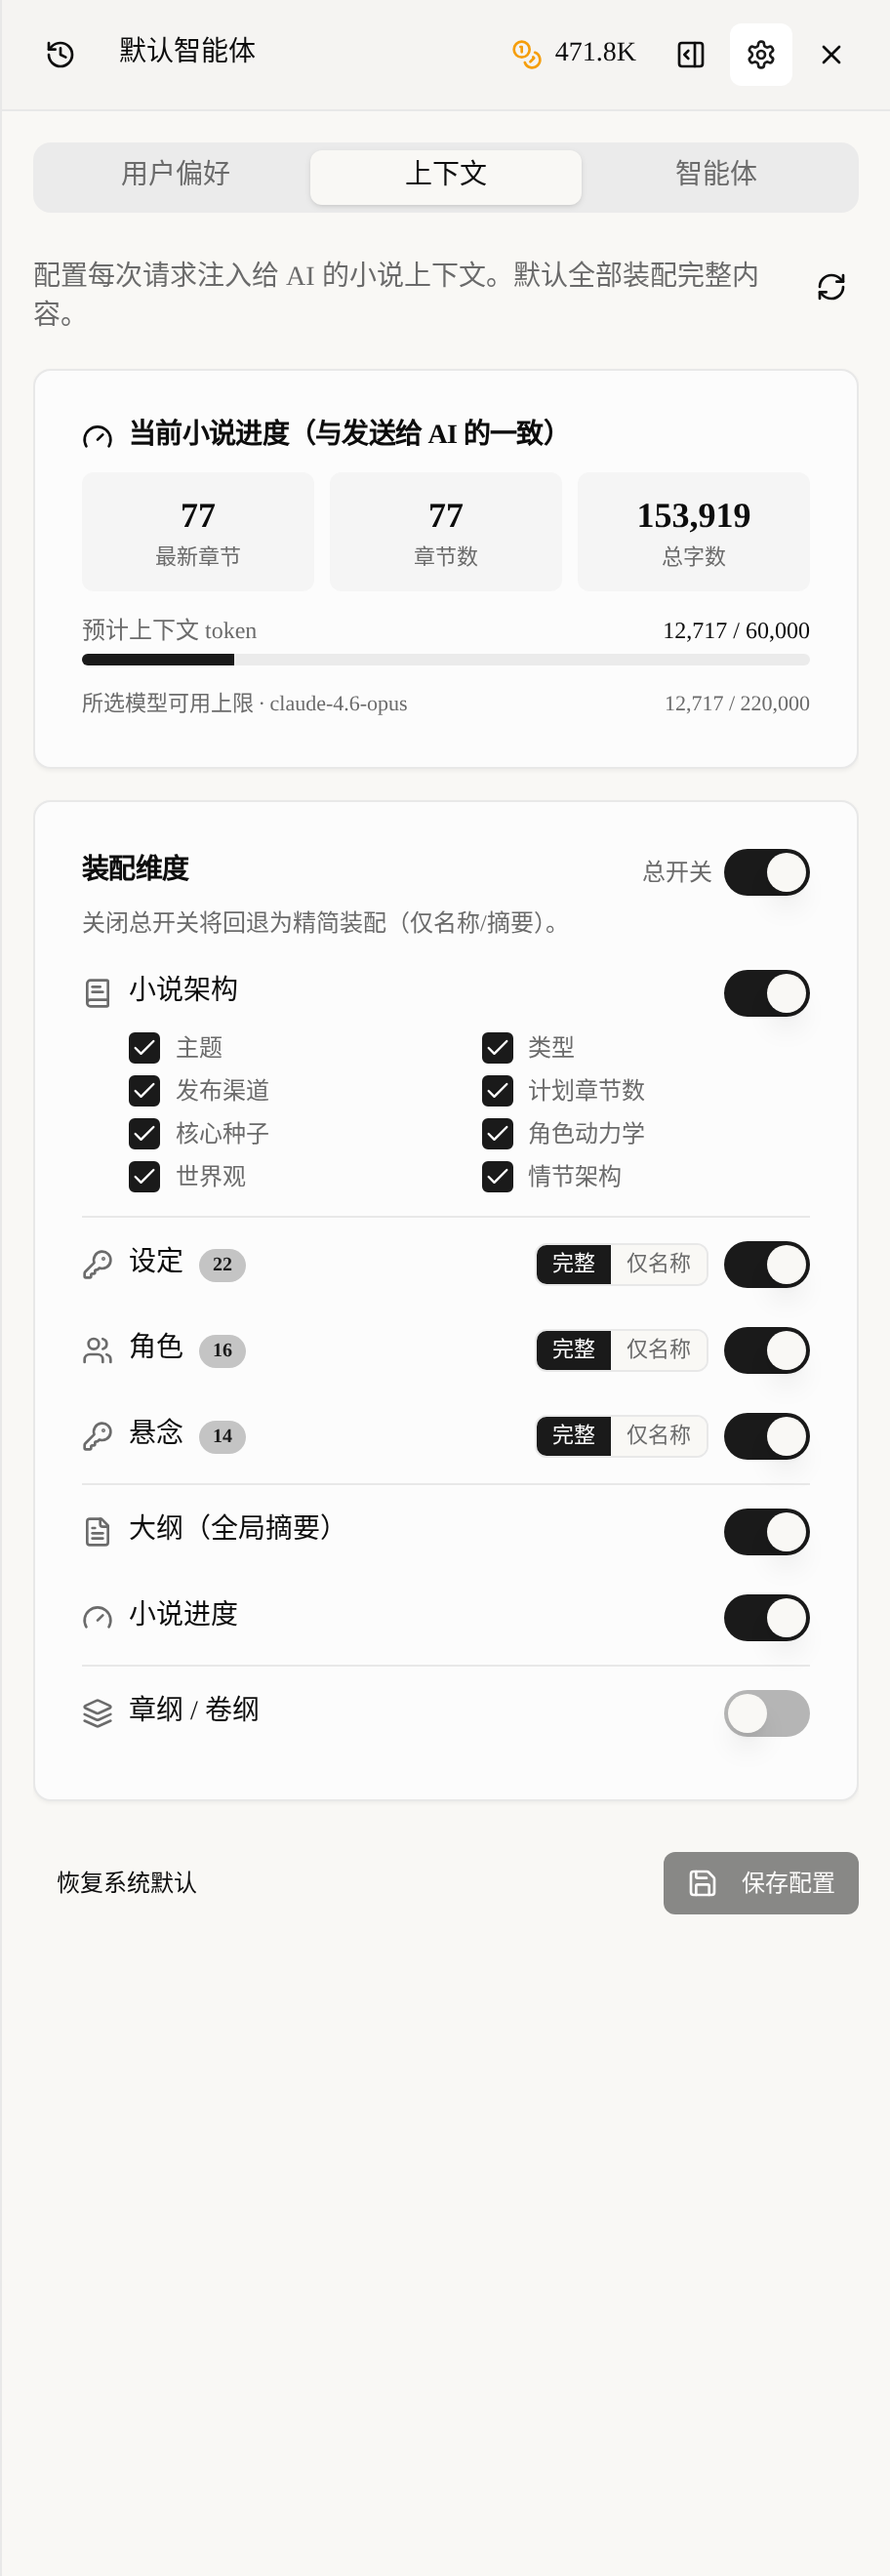
Chaque dimension a deux niveaux : « complet » et « nom seul ». « Nom seul » dit simplement à l’IA « ces personnages, ces éléments de bible existent », sans détailler — c’est la plus grosse économie de tokens. La barre de progression en haut du panneau estime en temps réel combien de tokens cet assemblage coûtera à peu près, et la compare à la limite par défaut de 60 000 ; si elle vire au rouge, il faut alléger.
Dosage mesuré : pour écrire en masse des chapitres ordinaires, mettez bible et personnages en « nom seul », désactivez les suspenses, ne donnez que les plans de chapitre « du tome en cours » : c’est assez pour que l’IA ne dévie pas, et cela réduit la consommation par appel au minimum ; ce n’est que pour les chapitres de tournant clé qu’on passe à « complet + plans des N derniers chapitres ».
Pour toute la marche à suivre, voir Comment configurer l’assemblage du contexte (économiser des crédits sans dévier).
Étape 3 : maîtriser spoilers et rythme avec la visibilité
Ce que redoute le plus un roman long, c’est que l’IA divulgâche à l’avance. Vous avez préparé pendant trois tomes l’instigateur caché, et l’IA le fait dire à un personnage dès le tome 1 : le suspense de tout le livre est ruiné. La « visibilité de la bible » de Maliang Writer est faite pour cela : chaque élément de bible, personnage ou suspense peut être caché séparément à l’IA, ou ouvert progressivement tome après tome.
La logique de l’« ouverture progressive par tome » est simple : vous cochez « rendre public à partir de quel tome », et quand la progression d’écriture atteint ce tome, cette information entre automatiquement dans le champ de vision de l’IA. Pour les chapitres précédents, l’IA n’en sait rien du tout, donc ne peut naturellement rien laisser échapper.
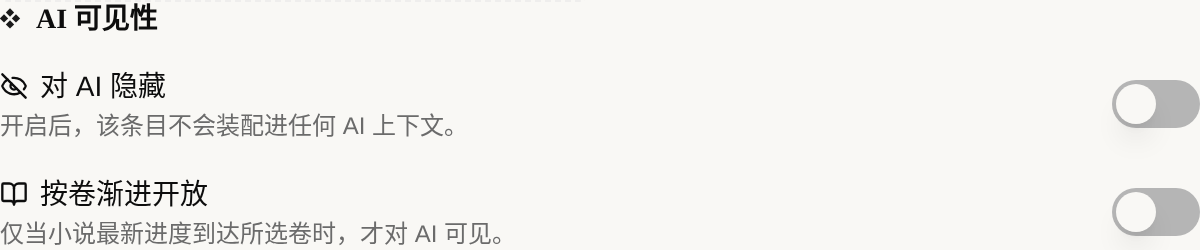
Retenez une règle de priorité : la visibilité est une « ligne rouge », l’assemblage du contexte est un « quota ». Les entrées masquées ou pas encore arrivées au tome d’ouverture n’entreront jamais dans le contexte, quel que soit le réglage de l’assemblage. Vous pouvez donc activer en toute confiance « bible complète » dans l’assemblage, et laisser la visibilité garder les vrais points de spoiler. Pour les détails, voir Masquer la bible et l’ouvrir progressivement par tome.
Étape 4 : donner une persona à l’IA pour unifier le style du livre
L’antidote à la dérive de style, c’est de donner à l’IA une persona fixe, au lieu de tout réexpliquer à chaque fois. L’agent personnalisé (Persona) de Maliang Writer vous permet d’écrire un prompt de persona et de le lier à un Agent précis ; dès lors, cette IA travaille selon cette persona.
La présentation de la persona est placée tout au début du prompt système de l’Agent choisi, comme directive de plus haut niveau, et les documents associés sont ajoutés à la fin comme référence. L’ordre d’injection est fixe : présentation de la persona (au début) + prompt d’origine de l’Agent + documents associés (à la fin).
Points d’écriture : une persona doit être exécutable. « Écris de façon plus brillante », l’IA ne peut pas l’appliquer ; « utilise beaucoup de phrases courtes et de descriptions d’action, pas plus de trois lignes par paragraphe, refuse les adjectifs creux » est une instruction qu’elle sait mettre en œuvre. Si vous ne voulez pas partir de zéro, les agents officiels proposent des modèles comme « Style Fanqie », « Les trois premiers chapitres d’or » ou « Maître de l’élimination de l’effet IA », directement importables.
Notez une règle de liaison : chaque Agent ne peut être lié qu’à un seul agent personnalisé à la fois ; si vous cochez un nouvel agent personnalisé sur un Agent déjà occupé, l’ancienne liaison est automatiquement supprimée à l’enregistrement. Pour l’explication complète, voir le tutoriel de l’agent personnalisé ; pour la rédaction des prompts, voir le guide des prompts d’écriture IA.
Étape 5 : garantir la cohérence avec le graphe de connaissances
Les quatre premières étapes gèrent l’« entrée », celle-ci gère la « mémoire ». Le graphe de connaissances est le cerveau externe de l’IA : il enregistre en continu la position, le niveau, les relations actuels des personnages, les objets et artefacts déjà apparus, les informations d’intrigue déjà révélées, pour que l’IA « consulte les archives » avant d’écrire le chapitre suivant.
C’est la clé pour résoudre l’« amnésie ». La fenêtre de contexte du modèle est limitée, mais le graphe de connaissances ne l’est pas — il stocke de façon structurée les états clés de tout le livre et les retrouve à la demande, comme un disque dur qui ne déborde jamais pour l’IA.
Point de vue exclusif : beaucoup pensent qu’il suffit de « changer pour un modèle à contexte plus grand » pour résoudre les incohérences, ce qui est faux. Une fenêtre, si grande soit-elle, a toujours une limite, et y faire entrer tout le livre est à la fois coûteux et lent. Mémoire externe (graphe de connaissances) + assemblage à la demande : c’est la vraie solution durable pour un roman long.
Pour le mécanisme, voir Comment le graphe de connaissances évite les incohérences et le guide pratique de la cohérence des romans longs.
Le « avant / après le cadre » en un tableau
Le tableau comparatif suivant montre ce que ce cadre change vraiment :
| Dimension | Sans cadre (longue conversation seule) | Avec le cadre de création de roman long |
|---|---|---|
| Cohérence de la bible | Contradictions fréquentes après 200 000 à 300 000 signes | Tout le long garantie par le graphe de connaissances |
| Risque de spoiler | L’IA peut à tout moment laisser échapper une amorce | La visibilité verrouille les points de spoiler par tome |
| Stabilité du style | Dérive de plus en plus | Persona fixe, style unifié sur tout le livre |
| Coût en tokens | La documentation s’accumule, le coût grimpe | Assemblage selon la situation, paiement à la demande |
| Maîtrise | À chaque modification, tout réexpliquer | Configurer une fois, effet durable |
Le cadre ne bride pas la création : il confie au système « ce qu’on ne doit pas laisser au hasard », pour que vous gardiez votre énergie pour les chapitres forts qui ont vraiment besoin d’inspiration.
Questions fréquentes
Q : Ce cadre convient-il à tous les genres ?
Oui. Que ce soit xuanhuan, romance, roman urbain ou historique, les causes de l’effondrement d’un roman long sont toujours le contexte, la mémoire et le style, et le cadre les traite. La différence ne tient qu’au dosage : un xuanhuan à bible forte doit donner plus d’univers, une romance très émotionnelle peut économiser sur la bible et garder davantage les fiches de personnages.
Q : Dois-je faire les cinq étapes pour que ça marche ?
Non. Chacune des cinq étapes agit seule, et vous pouvez commencer par la plus douloureuse. L’ordre le plus courant : d’abord le plan en trois niveaux pour stopper l’abandon en cours de route, puis l’assemblage du contexte pour économiser des crédits, enfin la visibilité et la persona. L’effet est maximal en les combinant, mais n’importe laquelle seule vaut mieux que la « longue conversation brute ».
Q : L’assemblage du contexte donnera-t-il aussi mes points de spoiler à l’IA ?
Non, à condition de bien utiliser la visibilité. La visibilité est la ligne rouge, l’assemblage est le quota : les entrées « masquées à l’IA » ou pas encore arrivées au tome d’ouverture n’entrent jamais dans le contexte, quel que soit le réglage de l’assemblage. Activez donc en confiance « bible complète », et laissez la visibilité garder les vrais retournements.
Q : Si je m’aperçois à mi-parcours que je n’ai rien planifié, puis-je encore appliquer le cadre ?
Oui. Complétez d’abord le plan général et les plans de tome (les plans de chapitre peuvent être complétés au fil de l’eau), puis saisissez dans la barre de documentation la bible et les personnages déjà écrits en réglant leur visibilité, et enfin liez la persona. Le cadre est « montable à tout moment », il n’exige pas de l’utiliser dès le premier chapitre.
Q : Avec le cadre, n’ai-je plus du tout besoin de contrôler à la main ?
Au contraire. Le cadre permet à l’IA de produire de façon stable dans les règles, mais nous vous conseillons de peaufiner vous-même les chapitres de climax et les tournants clés. Le bon partage : l’humain s’occupe de l’âme et des temps forts, l’IA de l’exécution en série dans l’ossature, et vous vous concentrez sur le contrôle de la qualité.
Pour finir
Un roman long ne s’écrit pas, il se « construit ». Le plan en trois niveaux lui donne sa colonne vertébrale, l’assemblage du contexte son champ de vision, la visibilité sa mesure, l’agent personnalisé sa voix, le graphe de connaissances sa mémoire — une fois ces cinq étapes en place, l’IA peut vous accompagner sur un million de signes.
Pour vous lancer tout de suite, commencez par le tutoriel d’assemblage du contexte et le système de plan en trois niveaux ; pour voir d’abord le flux complet d’écriture de roman avec l’IA, lisez le tutoriel complet pour écrire un roman avec l’IA. Une fois le cadre en place, il ne reste plus qu’à vous asseoir et à écrire, un chapitre après l’autre.