2026 AI写小说用哪个模型?Claude、Gemini、GPT、DeepSeek选型与同题测试
写小说选哪个AI,先比较你的题材和任务,而不是照搬总榜。这里提供Claude、Gemini、GPT、DeepSeek的官方核对入口、原创同题测试、可复制评分表,以及把重试和人工修改算进去的成本方法,帮助选择日更、对白和长篇续写方案。
马良写作团队
马良写作
AI写小说用哪个模型?先按你的任务选
日更正文,选你改动最少、总成本能接受的模型;悬疑和群像,先看因果、人设与信息边界;长篇续写,必须拿已有设定和章节实测,不能把上下文窗口当成记忆保证。 Claude、Gemini、GPT、DeepSeek 都可以进入候选,但品牌名不是具体版本,同一版本在不同平台上的参数、限额和费用也不一定相同。
第一次选型,不必同时试十个模型。先挑两个你能正常使用的版本,用下面同一份故事材料分别做大纲、对白、改稿,再遮住名字比较。结果接近时,优先选择更稳定、修改负担更小的那个,而不是追逐一个没有样本的“文笔第一”。
本页的证据范围:这是选型与自测指南,不是新一轮模型排名。2026-09-06 修订时,旧版评分、百万字成本估算和“完整记住前100章”等表述没有可供读者复算的充分证据,现不再作为排名结论。下文故事与正反例是为说明检查方法构造的教学材料,不是任何模型的实测输出。官方链接用于核对产品与评测方法,不证明某个模型的小说文笔领先。
先缩小候选:你最常卡在哪一步?
| 创作任务 | 首先比较什么 | 用什么现象判断不适合 | 通过后再比较 |
|---|---|---|---|
| 每天持续写正文 | 同一题材中可保留的段落、重复表达、稳定性 | 每章都要重写叙述口吻,或经常截断 | 实际扣费、首段等待、修改时间 |
| 角色对白与感情戏 | 每个人说话是否有动机、有区别 | 所有人同一口吻,靠旁白解释情绪 | 节奏、潜台词和你的个人偏好 |
| 悬疑、群像和伏笔 | 谁知道什么、证据顺序、因果链 | 提前泄露真相,角色使用尚未获得的线索 | 表达自然度、修改成本 |
| 长篇续写 | 关键设定能否在需要时正确使用 | 忘记伤势、物品归属、时间或人物关系 | 输入成本、上下文整理和响应时间 |
| 大纲与改稿 | 建议是否具体、是否符合你给定的目标 | 只说“增加冲突”,却不给事件和代价 | 方案差异、可执行性和费用 |
这张表是选择顺序,不是厂商品牌排行榜。写言情和写硬科幻的作者可以得到不同结果;同一作者也可以为规划、正文和检查选择不同模型,但要留意更换模型后的叙述风格断裂。
Claude、Gemini、GPT、DeepSeek:先核对版本,再做比较
| 候选模型族 | 使用前核对 | 小说试题重点 | 官方信息入口 |
|---|---|---|---|
| Claude | 确切模型 ID、思考设置、输入与输出限制 | 对白动机、叙述口吻、按修改意见重写 | 模型目录、价格 |
| Gemini | 稳定版还是预览版、实际端点、上下文与输出限制 | 多章资料引用、遗漏设定、图文资料任务 | 模型目录、价格 |
| GPT | 具体版本、推理设置、使用的是聊天产品还是 API | 大纲因果、约束执行、按证据改稿 | 模型目录、价格 |
| DeepSeek | 实际模型版本、思考模式、缓存和输出计费口径 | 中文题材表达、人物一致性、正文修改量 | 模型与价格 |
“试题重点”是本指南建议检查的方面,不是断言其他模型不具备这些能力。平台只显示“高级模型”或“智能模式”时,先记录可见档位,不要自行替它标注一个底层模型 ID。
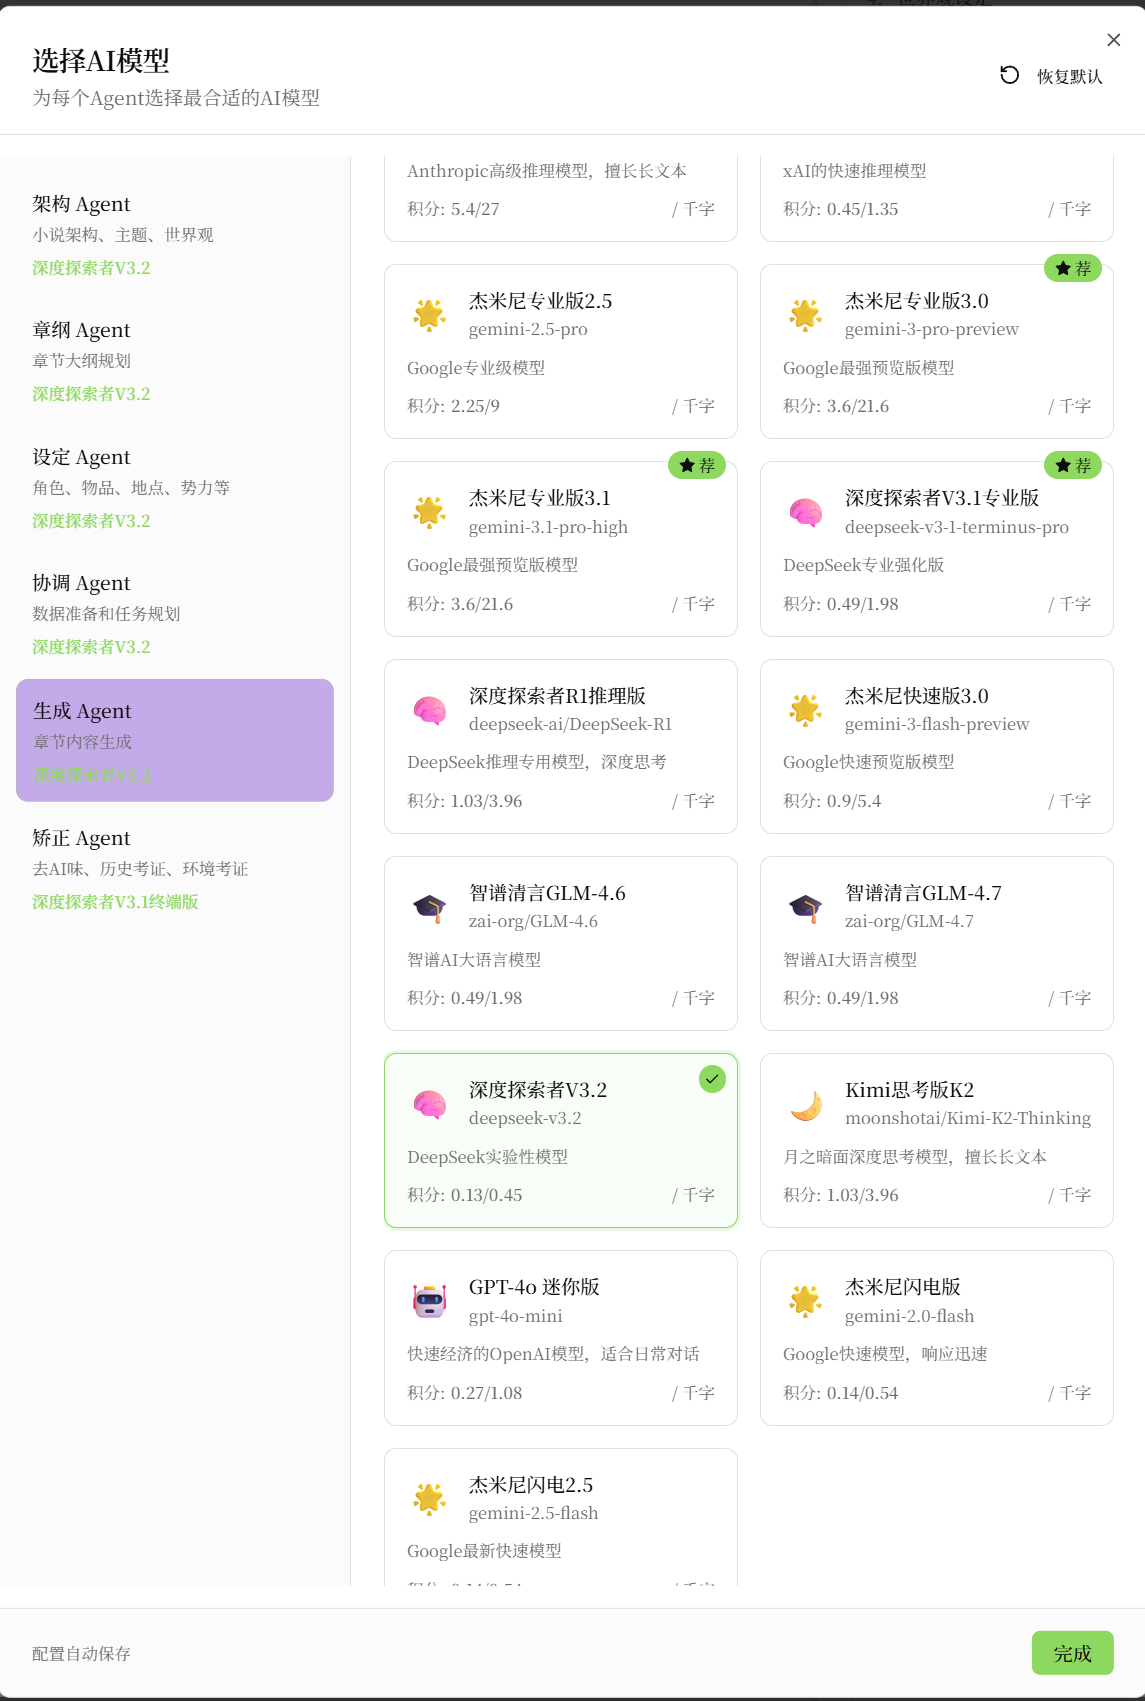
官方 API 的标价也不等于聊天产品订阅价,更不等于马良写作积分价格。站内是否提供某个版本,以当前功能的模型选择界面为准;写过一篇介绍文章,不代表该版本已接入。马良的价格与周期见价格与套餐,功能入口见多模型设置说明。
同题测试:拿同一份故事材料,做三种任务
保存完整同题试用包与空白记录表。材料与本页共用同一份题目来源,文件不含预填成绩,也不要求注册。
下面是本指南原创的练习材料,可以用于个人选型。也可以替换成你有权使用的一小段作品;不要上传未获授权的他人稿件或包含私人信息的材料。对每个候选使用完全相同的设定、任务和输出长度要求。
固定故事设定
故事:雨夜的渡口

人物与事实:
1. 祁岸是修伞匠,右腕受伤,不能用右手提重物。
2. 陆遥是渡口记账员,记得船次,但不识字。
3. 一封未拆的信在祁岸外衣内袋,只有祁岸知道它在那里。
4. 铜钥匙已经交给船夫,不能无说明地回到祁岸手里。
5. 大钟敲第三下后,最后一班渡船才离岸。
6. 本场景只采用祁岸的有限视角;不能直接写陆遥的内心。

眼前目标:
祁岸想在离船前确认陆遥有没有说谎,但不想暴露信的存在。
陆遥希望祁岸留下,却不能靠直接表白解决冲突。

结尾方向:
双方关系发生一次小变化,留下一个可在下一章验证的疑点,
不在本场揭晓信的内容。
任务一:大纲是否有因果,而不只是六个漂亮标题
请根据固定设定,写六个连续情节点。
每点写出:谁采取行动、行动付出什么代价、造成什么变化。
总长度控制在300—450个中文字符,不计空白。
不能增加能直接解决冲突的新人物或新道具。
输出大纲,不要写正文。
检查每个转折是否由前一步引出。把人物名遮掉后,六点仍然能套进任何故事,通常意味着方案还不够具体。
任务二:对白能否体现两个人不同的目的
请根据固定设定,写一段500—700个中文字符的场景,不计空白。
至少四次对白轮换;对白与动作交织,不单列人物标签。
保持祁岸的有限视角,不能直接解释陆遥心里在想什么。
两个人各自尝试改变对方的决定;结尾不要直接和解。
只输出正文。
不要只评“有没有金句”。更值得标记的是:哪句话在试探,哪个动作在回避,说完后局面有没有变化。
任务三:收到修改意见后,会不会弄坏没让它改的地方
对每个模型分别使用它在任务二中的完整输出,再附上同一条修改意见:
保持已有事实、物品归属、时间顺序和人物关系。
删去解释性心理总结,让最后的疑点由一个可观察的动作呈现。
保持原有视角,不揭开信,不增加人物。
输出修改后的完整场景,再单列不超过三条修改说明。
这一步评估的是“从各自初稿到各自改稿”的完整工作流,不是同输入的纯改写比较。需要单独比较改写能力时,另选一份相同、已冻结的初稿交给所有模型,两个实验的结果不要混合平均。
小样本用法:每个模型将三项任务做两遍;两个模型总共得到十二份任务输出。每遍使用新的干净会话;任务三沿用本遍任务二的初稿。保留每次结果和失败,不只挑最好的一篇。相同题目反复运行不是十二道独立题目,更不能代表所有题材。初筛后再用自己的几种不同章节复核。
如何判断:先查硬约束,再盲看文笔
先记下六条固定事实有没有被破坏。不要让漂亮措辞掩盖“右腕受伤却右手搬箱”“不识字却直接读信”这种可定位的问题。
下面两段是为说明检查方法构造的教学正反例,不是模型跑分:
反例:祁岸右手提起木箱,把铜钥匙拍在桌上。陆遥看清他内袋信上的字,终于明白了他的来意。
它同时违反受伤限制、钥匙归属和信息边界,还把“不识字”的角色写成了能读信。
修正示例:祁岸把木箱往左脚边推了推,没有伸手。陆遥又问了一遍船次,他却先看向钟楼。第三声还没响。
第二段只是说明如何不破坏已知事实,不代表它在文学上必然更好。冲突是否足够、语言是否贴合题材,仍需要你判断。
把模型名换成 A、B,交错阅读,并为每一项保留具体句子作为理由:
| 检查项 | 记录方法 |
|---|---|
| 事实和视角 | 逐条标记通过、失败或无法判断,附原句 |
| 因果与信息增量 | 说清发生了什么变化,不能只给“顺畅”这种评语 |
| 人物声音 | 找出一句只有这个人物会说的话;找不到也如实记录 |
| 修改后的完整性 | 对照初稿,标出未经要求新增、删除或改坏的事实 |
| 采用程度 | 标出实际保留的段落与修改时间,不把输出长度当采用量 |
| 稳定性 | 两遍差异、截断、拒答、超时分别记录;一次表现好不是稳定性结论 |
不熟悉盲评时,可以先看 OpenAI 的评测方法:按真实任务设计评估,避免只有主观印象,并对评估本身做核验。这个方法参考不等于 OpenAI 对本页模型选型结果的背书。
写小说花多少钱?算“每千采用字”,别只算每次生成
至少分开记录四件事:实际输入费用、输出费用、已计费的重试费用、人工修改时间。不要把中文字符数与 token 数按固定比例互换,也不要把不同币种直接相加。
每千采用字的模型费用
= 同一组任务的实际模型费用合计 ÷ 最终采用的中文字符数 × 1000

另外记录:人工修改分钟数、首段等待秒数、总完成时间。
如果采用字数为0,记“没有可采用产出”,不要记成零成本。
仅作算式示例,不是报价或实测:某次初稿与重试合计花了2元,最后采用1,600字,模型费用就是每千采用字1.25元。若还改了半小时,半小时也应该进入你的决策。更便宜的单次调用,不一定对应更便宜的可用章节。
开发者自行调用 API 时,还应按所用服务的账单区分缓存命中、未命中输入与输出;细则见 Claude 价格、Gemini 价格、GPT 价格与 DeepSeek 价格。本指南不把渠道报价转换成“写百万字固定多少钱”的保证。
长篇续写:大窗口和可靠记忆是两件事
短场景通过后,再用已有章节复核。把检查点放在开头、中间和接近当前章的不同位置,分别检查人物身份、伤势、物品、时间线和未公开信息;让续写真的用到这些条件,而不只是问它能否复述。
材料超过实际输入限制时,记录你如何裁剪、摘要或选择上下文。比较不同模型时,应先做同材料输入的对照;再把各平台提供的上下文管理作为另一个工作流实验。不能一边完整提供资料、一边只给摘要,最后把差异全归因给模型本身。
《Lost in the Middle》研究讨论了被测语言模型对长上下文中不同位置的信息使用差异。它不是2026年所有模型的排名,也不能替代你当前版本的复测。对创作而言,稳妥做法是保留设定表、近期事件和人物信息边界,并在换模型后重新检查。
需要整理长篇材料时,可继续看长篇创作框架和上下文装配教程。这里讨论使用方法,不要求你为了选模型改造整套写作系统。
在马良里怎么开始,不用先换掉整本书的模型
先选一段有代表性的现有章节,保留原稿与设定,再打开当前功能的模型设置确认实际可用版本。只在这个片段上做对比,满意后再决定是否扩展。不同写作任务使用不同模型时,保留统一的角色口吻、视角和叙述要求。
还没有大纲时,先用小说大纲模板明确人物目标、阻碍与章节变化;还没有开始写第一章,可接着看AI写小说入门流程。这些材料准备不足时,直接更换更贵的模型未必解决问题。比较对白口吻时,可参考个人文风与角色声音指南;处理复制产生的空行和标点时,可先用免费文本排版,但排版结果不能充当文笔评分。
常见问题
哪个AI写小说最好?
本页没有足够证据给出跨题材、跨版本的统一冠军。对你最好的候选,应当在自己的同题测试中保留更多可采用内容,较少破坏设定,并满足预算与等待时间要求。先做一个小范围对比,再决定主力模型。
更大的上下文窗口,就能保证长篇不吃书吗?
不能仅凭窗口规格作出保证。输入容量、资料是否完整、信息位置和生成时能否正确使用,分别需要检查。用会影响当前剧情的设定测试,而不是只问模型“记不记得”。
思考强度开到最高,正文一定更好吗?
本页不作这种保证。先固定参数建立基线,再单独改变思考设置,比较实际输出、等待和费用。不要同时更换模型、提示词、材料和推理设置后,仍将结果当作单一变量实验。
这份指南是否保证过审、签约或检测结果?
不保证。小说质量、平台规则和检测结果是不同问题;选型测试也不能证明文本由真人创作。投稿前应查看目标平台当时的正式规则。
本次修订与来源
2026-09-06:保留原页面地址和首次发布时间,改为可复核的选型指南;提供原创测试题和教学正反例,撤下缺少可复算依据的旧评分、绝对记忆与固定百万字成本结论。本次没有开展新的付费模型横评。
官方资料分别用于型号/价格核对与评测方法参考;实际产品支持以所用服务为准。正文中的故事、表格和成本算式是本指南的教学材料。发现具体事实错误,可以通过内容反馈说明页面、原句及依据。
RELATED