AI 寫小說 token 暴漲、積分燒得快?智慧上下文裝配省 token 完全指南
一章沒寫幾個字,積分卻嘩嘩掉?本文講透 token 暴漲的根因與"智慧載入上下文"省 token 三步法:即時 token 估算、完整改僅名稱、章綱卷綱按需開,附三套實戰配比與超限保護機制說明。
本篇目錄 10 節
你只是讓 AI 續寫一段兩千字,積分卻掉了一大截。問題往往不在"輸出",而在"輸入"——每次寫作前,系統預設把整本書的架構、設定、角色、懸念全塞給了 AI,這部分"看資料"的開銷,才是 token 暴漲的真兇。
好訊息是:這部分完全可控。馬良寫作的"智慧載入上下文"讓你自己決定每次餵給 AI 多少資料。這一篇用三步法,教你把積分花在刀刃上。
核心要點
- token 暴漲主要來自"輸入端"——預設全量裝配小說資料,而非 AI 的輸出。
- 智慧載入上下文 = 按場景"按需裝配",而不是每次"全量塞入"。
- 馬良寫作傳送前會即時估算這套裝配的 token,並和預設上限 60,000 對比,飄紅即提醒。
- 省 token 三招:完整改"僅名稱"、章綱卷綱按需開、關掉用不上的維度。
token 為什麼會暴漲?
因為大模型的計費是按"輸入 + 輸出"總量算的,而輸入端的小說資料往往遠比你寫的那幾千字更佔地方。 一本書的全套設定、角色、懸念、架構疊起來,輕鬆就是幾萬 token,每寫一章都重複消耗一次。
很多人盯著"AI 寫了多少字"省錢,方向錯了。真正的大頭是"AI 每次讀了多少資料"。資料給得越全,AI 越不跑偏,但每一次生成的成本也越高——這是一個需要你主動權衡的天平。
實測觀察: 在我們的內部測試裡,把設定與角色從"完整"改成"僅名稱",單次寫作的上下文 token 通常能明顯下降,而對日常章節的寫作質量幾乎沒有可感知的影響。省錢的關鍵,是分清"哪些資料 AI 現在真的用得上"。
理解 AI 寫作的整體成本結構,可參考馬良寫作免費版 vs 付費版。
什麼是"智慧載入上下文"?
智慧載入上下文,是把"餵給 AI 多少資料"這個開關交到你手裡,按場景給量,而不是每次無腦全開。 它的反義詞是"全量塞入"——不管寫什麼都把整本書的資料一股腦發出去。
核心思想很樸素:AI 寫日常章節時,知道"有哪些角色、哪些設定存在"就夠了,細節它會按需問;只有寫關鍵轉折時,才需要完整資料兜底。智慧載入就是讓你針對不同場景,給出剛好夠用的資訊量。
獨家視角: 省 token 不等於"少給資料導致 AI 變笨"。恰恰相反——給得太多,關鍵資訊反而被淹沒,AI 抓不住重點。精準地"按需給",既省錢又常常寫得更聚焦。
入口在 AI 助手欄點齒輪"AI 功能管理",切到"上下文"標籤。完整說明見上下文裝配教程。
第一步:先看懂即時 token 估算
省錢的前提是先能"看見"花費。馬良寫作在你傳送前就即時估算這套裝配大概要花多少 token。 不用等扣了積分才後悔。
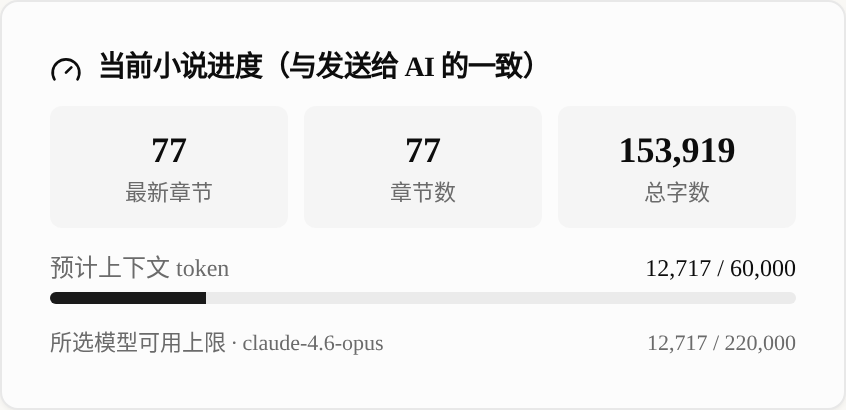
面板頂部有一條"預計上下文 token"進度條,後面跟著預設上限 60,000。它即時統計你當前這套裝配的開銷,飄紅就說明該精簡了。再往下還有一行"所選模型可用上限",會帶上你當前選的生成模型名字——有些模型窗口小,這裡會提前告訴你"這套它裝不下"。
記個簡單口訣:上面那條比的是"平臺預設上限",下面那行比的是"你選的模型能不能裝下"。兩條都不飄紅,就放心發。
第二步:把"完整"換成"僅名稱"
這是省 token 最立竿見影的一招。 滾到"裝配維度",設定、角色、懸念每一項都有"完整"和"僅名稱"兩檔。
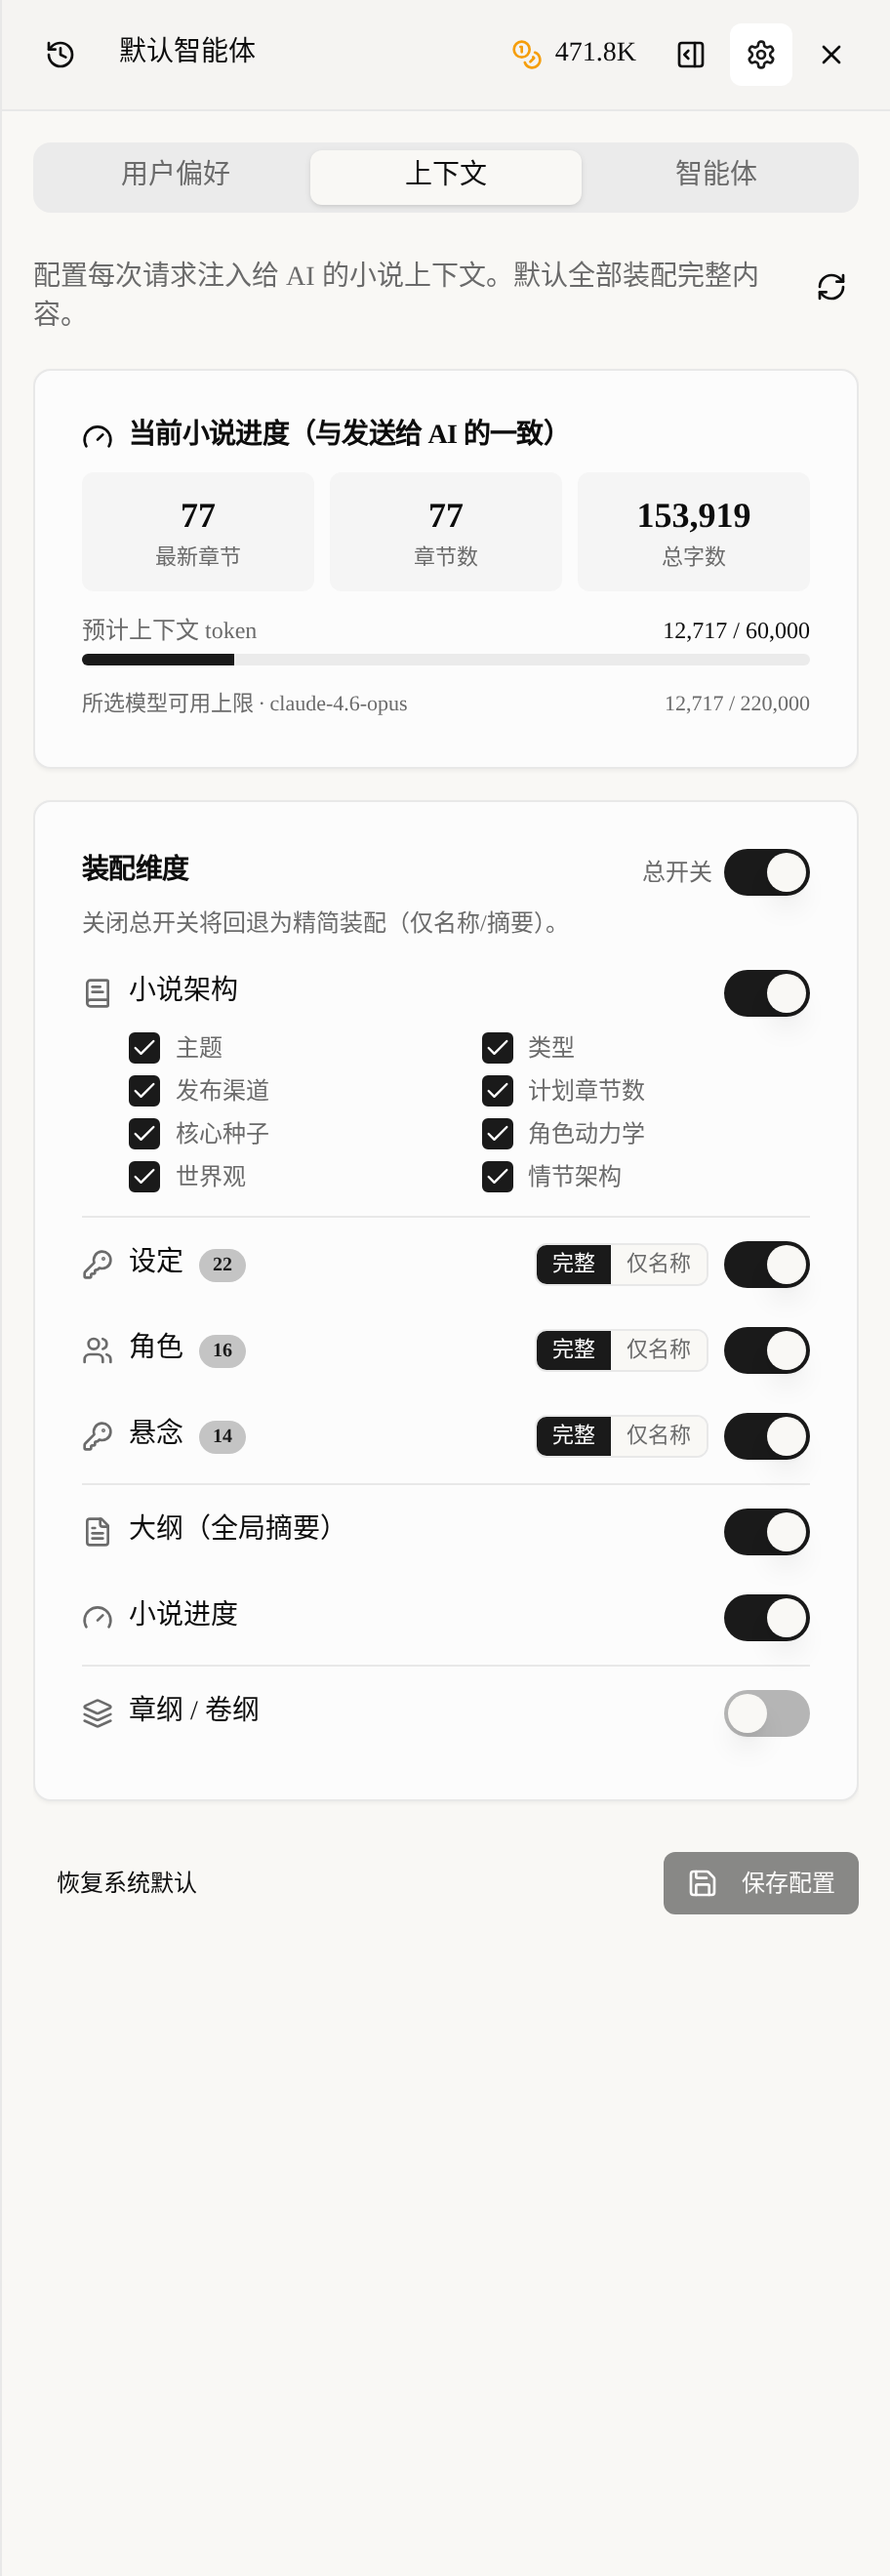
"完整"是把整條資料都給 AI,"僅名稱"只給名字列表,讓 AI 知道"有這些東西存在"但不展開細節。日常批次寫正文時,設定和角色用"僅名稱",AI 照樣認得人、不跑偏,token 卻能省下一大塊。
每項後面的小數字(比如"設定 22""角色 16")是這本書當前的條目數量,方便你判斷"全裝進去會不會太多"。右上角還有個"總開關",關掉它就回退成最省的"精簡裝配",純聊創意時很合適。
第三步:章綱卷綱按需開,別預設全裝
章綱卷綱是 token 大戶,預設是關的,開了能讓 AI 嚴格按大綱寫,但開銷會明顯上漲。 所以它是"按需開",不是"常開"。
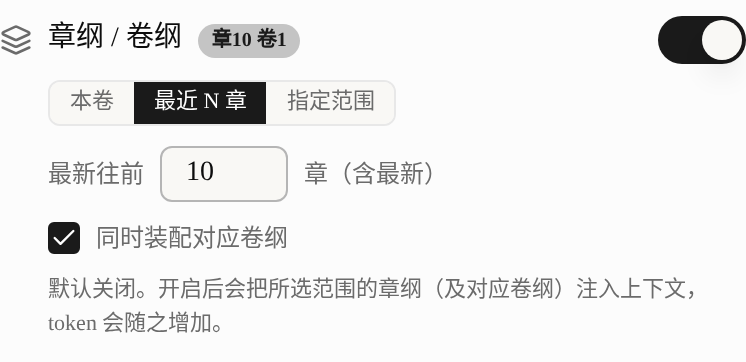
它有三種裝配範圍:"本卷"只給當前這一卷的章綱、"最近 N 章"從最新往前數 N 章、"指定範圍"手動填章節區間。下面還有"同時裝配對應卷綱"的勾選。開關旁的小徽標會告訴你這次實際裝配了多少章綱、多少卷綱。
省錢提醒: 平時擴寫、寫過渡章,章綱卷綱可以直接關掉;只在"讓 AI 嚴格踩著大綱走"的關鍵章再開,且優先用"本卷"或"最近 N 章",別動不動全書都裝。
三套省 token 實戰配比
不用每次都從頭調,按場景套用下面三套組合即可。 這是我們最常用的三檔:
| 場景 | 設定 / 角色 | 懸念 | 章綱卷綱 | 適用 |
|---|---|---|---|---|
| 大批次寫正文(最省) | 僅名稱 | 關閉 | 本卷 | 日常章節、過渡章 |
| 關鍵章節(求穩) | 完整 | 完整 | 最近 N 章 + 卷綱 | 高潮、轉折、揭曉 |
| 純聊創意(最輕) | 關總開關 | 關閉 | 關閉 | 頭腦風暴、對話靈感 |
改完別忘了點底部"儲存配置"——配置是按這本小說單獨存的,一本書設一次,長期生效。
獨家心得: 大多數章節其實都屬於"日常",真正需要"完整"的高光章佔比不高。把預設配比設成"最省",只在寫關鍵章時臨時升級,長期下來省下的積分相當可觀。
token 超限會怎樣?超限保護機制
如果你的裝配把預計 token 頂過了預設上限,系統會主動保護,而不是默默扣錢。 進度條會變紅,並彈出提示讓你去聊天設定裡打開"最大上下文"。
不打開"最大上下文"的話,超出的部分會被自動壓縮,AI 可能"看不全"——這時候寫出來的質量會打折。同理,如果超過了"所選模型可用上限",下面那行也會飄紅。
遇到飄紅有兩個辦法:要麼按上面的配比精簡維度(最省那套通常立刻就降下來了),要麼換一個上下文更大的模型。怎麼選模型,見AI 模型選擇指南。
還能怎麼省?兩個進階招
第一招,用可見性給上下文"減負"。 把短期用不上的設定、還沒到揭曉卷的伏筆設成"對 AI 隱藏"或"按卷漸進開放",它們就不會進上下文。這樣即便你開著"設定完整",實際裝配的也只是"當前該給的那部分",省錢又防劇透。具體見漸進式披露與設定可見性。
第二招,選對模型。 同樣的任務,不同模型的單價和上下文窗口差別很大。日常章節用價效比高的模型,關鍵章再切高階模型,是更經濟的搭配。
實戰提醒: 省 token 是"組合拳":智慧裝配減少輸入量,可見性砍掉不該給的條目,選模型優化單價。三招疊加,比單純壓縮任何一項都有效。把它放進你的長篇創作框架,長篇的成本才真正可控。
常見問題
Q:省 token 會不會讓 AI 寫得變差?
不會,前提是"按需給"而非"亂刪"。日常章節用"僅名稱",AI 知道有哪些人和設定就夠了,細節會按需調用;只有寫關鍵轉折才需要"完整"。給得太多反而會淹沒重點,精準給量常常寫得更聚焦。
Q:預設上限 60,000 token 能改嗎?超了一定要開"最大上下文"嗎?
60,000 是平臺預設上限。超了不開"最大上下文",超出部分會被自動壓縮,AI 可能看不全;開了則按你選的模型窗口儘量裝。建議先用最省配比把估算壓回上限內,實在需要大上下文再開。
Q:怎麼知道這次到底花了多少 token?
看面板頂部的"預計上下文 token"進度條,它在傳送前就即時估算,並和預設上限對比。下面那行"所選模型可用上限"還會告訴你當前模型能不能裝下。兩條都不飄紅就放心發。
Q:章綱卷綱到底要不要開?
按需開。它能讓 AI 嚴格踩著大綱寫,但是 token 大戶。平時擴寫、過渡章直接關;只在關鍵章開,且優先用"本卷"或"最近 N 章",不要全書都裝。
Q:配置是全局的還是每本書單獨的?
每本小說單獨存。你給某本書設的省 token 配比只作用於這本書,換一本書要重新配。改完記得點"儲存配置",否則下次進來又是預設的全量裝配。
寫在最後
AI 寫作的積分,大頭花在"讀資料"上,而讀多少資料,主動權在你手裡。看懂 token 估算、把"完整"換成"僅名稱"、章綱卷綱按需開——三步就能把成本壓下來一大截。
再疊上可見性減負和選對模型,省 token 就成了一套可複用的組合拳。現在就去上下文裝配教程按你的寫作節奏設好預設配比,讓每一分積分都花在真正需要的地方。