2026 AI寫小說用哪個模型?Claude、Gemini、GPT、DeepSeek選型與同題測試
寫小說選哪個AI,先比較你的題材和任務,而不是照搬總榜。這裡提供Claude、Gemini、GPT、DeepSeek的官方核對入口、原創同題測試、可複製評分表,以及把重試和人工修改算進去的成本方法,幫助選擇日更、對白和長篇續寫方案。
本篇目錄 10 節
AI寫小說用哪個模型?先按你的任務選
日更正文,選你改動最少、總成本能接受的模型;懸疑和群像,先看因果、人設與資訊邊界;長篇續寫,必須拿已有設定和章節實測,不能把上下文窗口當成記憶保證。 Claude、Gemini、GPT、DeepSeek 都可以進入候選,但品牌名不是具體版本,同一版本在不同平臺上的參數、限額和費用也不一定相同。
第一次選型,不必同時試十個模型。先挑兩個你能正常使用的版本,用下面同一份故事材料分別做大綱、對白、改稿,再遮住名字比較。結果接近時,優先選擇更穩定、修改負擔更小的那個,而不是追逐一個沒有樣本的“文筆第一”。
本頁的證據範圍:這是選型與自測指南,不是新一輪模型排名。2026-09-06 修訂時,舊版評分、百萬字成本估算和“完整記住前100章”等表述沒有可供讀者復算的充分證據,現不再作為排名結論。下文故事與正反例是為說明檢查方法構造的教學材料,不是任何模型的實測輸出。官方連結用於核對產品與評測方法,不證明某個模型的小說文筆領先。
先縮小候選:你最常卡在哪一步?
| 創作任務 | 首先比較什麼 | 用什麼現象判斷不適合 | 通過後再比較 |
|---|---|---|---|
| 每天持續寫正文 | 同一題材中可保留的段落、重複表達、穩定性 | 每章都要重寫敘述口吻,或經常截斷 | 實際扣費、首段等待、修改時間 |
| 角色對白與感情戲 | 每個人說話是否有動機、有區別 | 所有人同一口吻,靠旁白解釋情緒 | 節奏、潛臺詞和你的個人偏好 |
| 懸疑、群像和伏筆 | 誰知道什麼、證據順序、因果鏈 | 提前洩露真相,角色使用尚未獲得的線索 | 表達自然度、修改成本 |
| 長篇續寫 | 關鍵設定能否在需要時正確使用 | 忘記傷勢、物品歸屬、時間或人物關係 | 輸入成本、上下文整理和響應時間 |
| 大綱與改稿 | 建議是否具體、是否符合你給定的目標 | 只說“增加衝突”,卻不給事件和代價 | 方案差異、可執行性和費用 |
這張表是選擇順序,不是廠商品牌排行榜。寫言情和寫硬科幻的作者可以得到不同結果;同一作者也可以為規劃、正文和檢查選擇不同模型,但要留意更換模型後的敘述風格斷裂。
Claude、Gemini、GPT、DeepSeek:先核對版本,再做比較
| 候選模型族 | 使用前核對 | 小說試題重點 | 官方資訊入口 |
|---|---|---|---|
| Claude | 確切模型 ID、思考設定、輸入與輸出限制 | 對白動機、敘述口吻、按修改意見重寫 | 模型目錄、價格 |
| Gemini | 穩定版還是預覽版、實際端點、上下文與輸出限制 | 多章資料引用、遺漏設定、圖文資料任務 | 模型目錄、價格 |
| GPT | 具體版本、推理設定、使用的是聊天產品還是 API | 大綱因果、約束執行、按證據改稿 | 模型目錄、價格 |
| DeepSeek | 實際模型版本、思考模式、快取和輸出計費口徑 | 中文題材表達、人物一致性、正文修改量 | 模型與價格 |
“試題重點”是本指南建議檢查的方面,不是斷言其他模型不具備這些能力。平臺只顯示“高級模型”或“智慧模式”時,先記錄可見檔位,不要自行替它標註一個底層模型 ID。
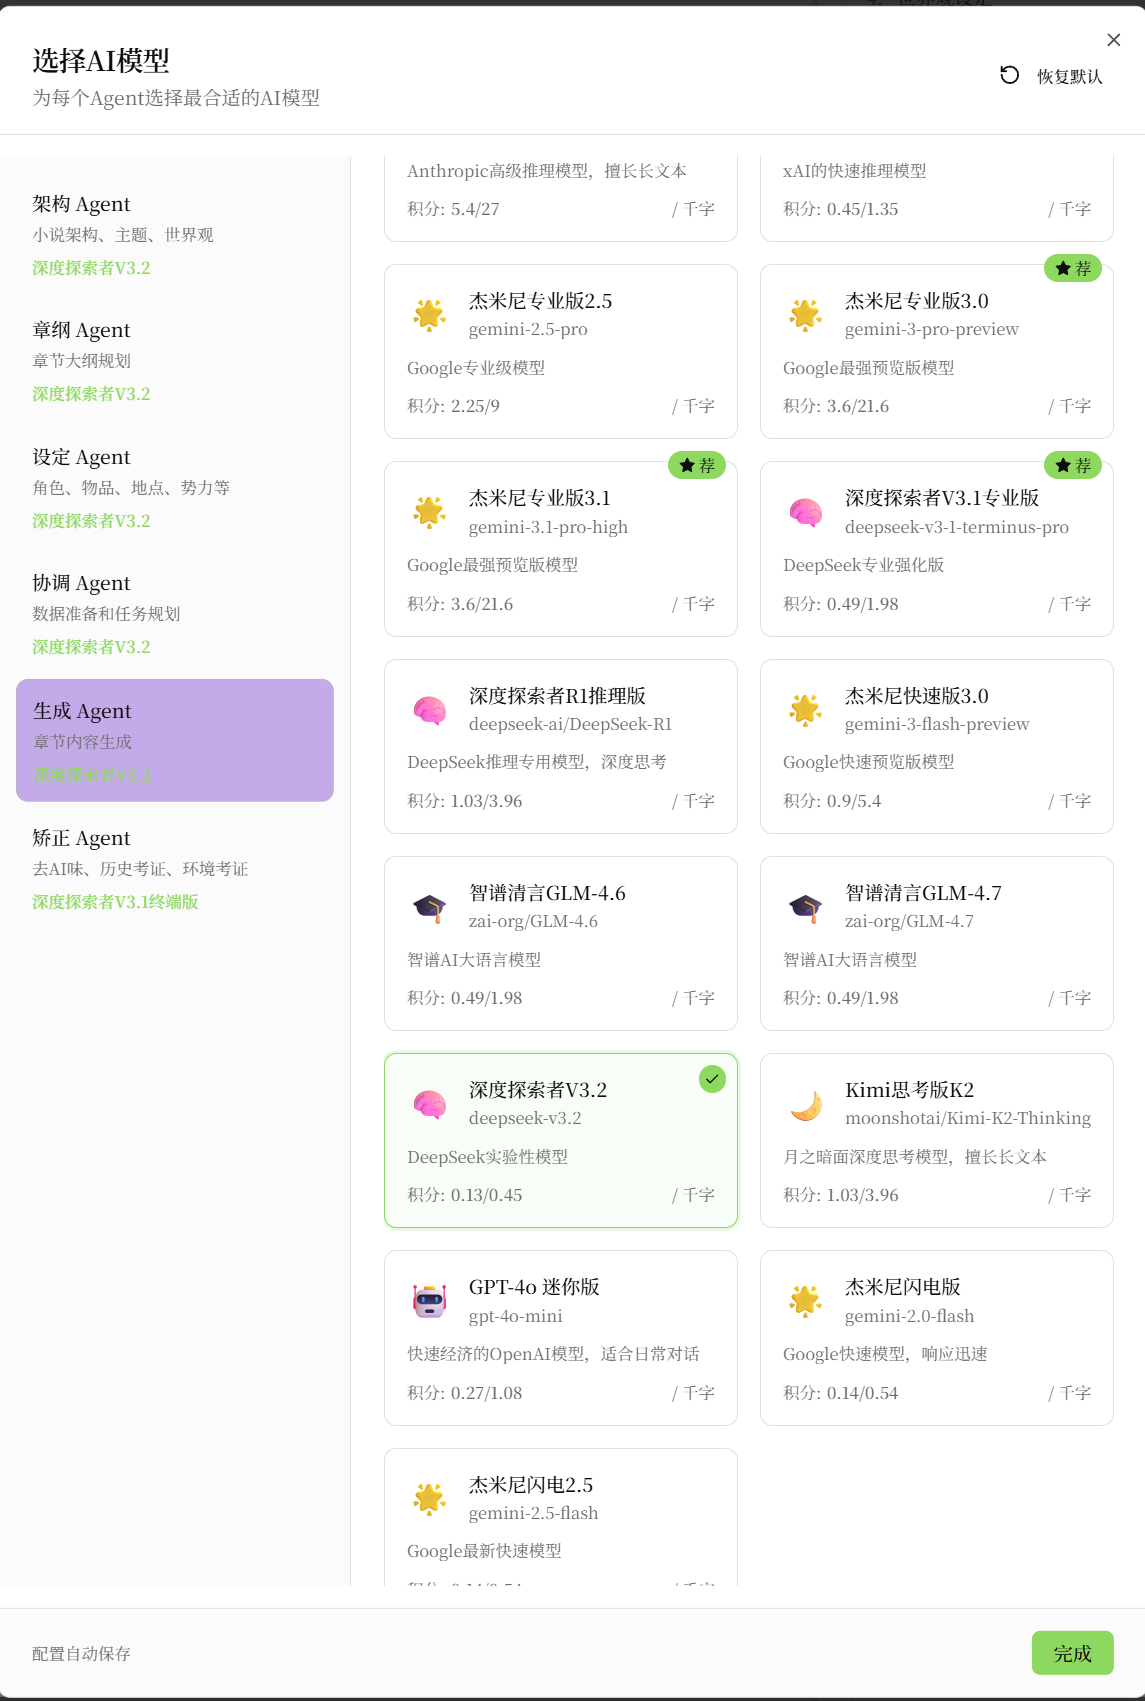
官方 API 的標價也不等於聊天產品訂閱價,更不等於馬良寫作積分價格。站內是否提供某個版本,以當前功能的模型選擇介面為準;寫過一篇介紹文章,不代表該版本已接入。馬良的價格與週期見價格與套餐,功能入口見多模型設定說明。
同題測試:拿同一份故事材料,做三種任務
儲存完整同題試用包與空白記錄表。材料與本頁共用同一份題目來源,文件不含預填成績,也不要求註冊。
下面是本指南原創的練習材料,可以用於個人選型。也可以替換成你有權使用的一小段作品;不要上傳未獲授權的他人稿件或包含私人資訊的材料。對每個候選使用完全相同的設定、任務和輸出長度要求。
固定故事設定
故事:雨夜的渡口

人物與事實:
1. 祁岸是修傘匠,右腕受傷,不能用右手提重物。
2. 陸遙是渡口記賬員,記得船次,但不識字。
3. 一封未拆的信在祁岸外衣內袋,只有祁岸知道它在那裡。
4. 銅鑰匙已經交給船伕,不能無說明地回到祁岸手裡。
5. 大鐘敲第三下後,最後一班渡船才離岸。
6. 本場景只採用祁岸的有限視角;不能直接寫陸遙的內心。

眼前目標:
祁岸想在離船前確認陸遙有沒有說謊,但不想暴露信的存在。
陸遙希望祁岸留下,卻不能靠直接表白解決衝突。

結尾方向:
雙方關係發生一次小變化,留下一個可在下一章驗證的疑點,
不在本場揭曉信的內容。
任務一:大綱是否有因果,而不只是六個漂亮標題
請根據固定設定,寫六個連續情節點。
每點寫出:誰採取行動、行動付出什麼代價、造成什麼變化。
總長度控制在300—450箇中文字元,不計空白。
不能增加能直接解決衝突的新人物或新道具。
輸出大綱,不要寫正文。
檢查每個轉折是否由前一步引出。把人物名遮掉後,六點仍然能套進任何故事,通常意味著方案還不夠具體。
任務二:對白能否體現兩個人不同的目的
請根據固定設定,寫一段500—700箇中文字元的場景,不計空白。
至少四次對白輪換;對白與動作交織,不單列人物標籤。
保持祁岸的有限視角,不能直接解釋陸遙心裡在想什麼。
兩個人各自嘗試改變對方的決定;結尾不要直接和解。
只輸出正文。
不要只評“有沒有金句”。更值得標記的是:哪句話在試探,哪個動作在迴避,說完後局面有沒有變化。
任務三:收到修改意見後,會不會弄壞沒讓它改的地方
對每個模型分別使用它在任務二中的完整輸出,再附上同一條修改意見:
保持已有事實、物品歸屬、時間順序和人物關係。
刪去解釋性心理總結,讓最後的疑點由一個可觀察的動作呈現。
保持原有視角,不揭開信,不增加人物。
輸出修改後的完整場景,再單列不超過三條修改說明。
這一步評估的是“從各自初稿到各自改稿”的完整工作流,不是同輸入的純改寫比較。需要單獨比較改寫能力時,另選一份相同、已凍結的初稿交給所有模型,兩個實驗的結果不要混合平均。
小樣本用法:每個模型將三項任務做兩遍;兩個模型總共得到十二份任務輸出。每遍使用新的乾淨會話;任務三沿用本遍任務二的初稿。保留每次結果和失敗,不只挑最好的一篇。相同題目反覆運行不是十二道獨立題目,更不能代表所有題材。初篩後再用自己的幾種不同章節複核。
如何判斷:先查硬約束,再盲看文筆
先記下六條固定事實有沒有被破壞。不要讓漂亮措辭掩蓋“右腕受傷卻右手搬箱”“不識字卻直接讀信”這種可定位的問題。
下面兩段是為說明檢查方法構造的教學正反例,不是模型跑分:
反例:祁岸右手提起木箱,把銅鑰匙拍在桌上。陸遙看清他內袋信上的字,終於明白了他的來意。
它同時違反受傷限制、鑰匙歸屬和資訊邊界,還把“不識字”的角色寫成了能讀信。
修正示例:祁岸把木箱往左腳邊推了推,沒有伸手。陸遙又問了一遍船次,他卻先看向鐘樓。第三聲還沒響。
第二段只是說明如何不破壞已知事實,不代表它在文學上必然更好。衝突是否足夠、語言是否貼合題材,仍需要你判斷。
把模型名換成 A、B,交錯閱讀,併為每一項保留具體句子作為理由:
| 檢查項 | 記錄方法 |
|---|---|
| 事實和視角 | 逐條標記通過、失敗或無法判斷,附原句 |
| 因果與資訊增量 | 說清發生了什麼變化,不能只給“順暢”這種評語 |
| 人物聲音 | 找出一句只有這個人物會說的話;找不到也如實記錄 |
| 修改後的完整性 | 對照初稿,標出未經要求新增、刪除或改壞的事實 |
| 採用程度 | 標出實際保留的段落與修改時間,不把輸出長度當採用量 |
| 穩定性 | 兩遍差異、截斷、拒答、超時分別記錄;一次表現好不是穩定性結論 |
不熟悉盲評時,可以先看 OpenAI 的評測方法:按真實任務設計評估,避免只有主觀印象,並對評估本身做核驗。這個方法參考不等於 OpenAI 對本頁模型選型結果的背書。
寫小說花多少錢?算“每千採用字”,別隻算每次生成
至少分開記錄四件事:實際輸入費用、輸出費用、已計費的重試費用、人工修改時間。不要把中文字元數與 token 數按固定比例互換,也不要把不同幣種直接相加。
每千採用字的模型費用
= 同一組任務的實際模型費用合計 ÷ 最終採用的中文字元數 × 1000

另外記錄:人工修改分鐘數、首段等待秒數、總完成時間。
如果採用字數為0,記“沒有可採用產出”,不要記成零成本。
僅作算式示例,不是報價或實測:某次初稿與重試合計花了2元,最後採用1,600字,模型費用就是每千採用字1.25元。若還改了半小時,半小時也應該進入你的決策。更便宜的單次調用,不一定對應更便宜的可用章節。
開發者自行調用 API 時,還應按所用服務的賬單區分快取命中、未命中輸入與輸出;細則見 Claude 價格、Gemini 價格、GPT 價格與 DeepSeek 價格。本指南不把渠道報價轉換成“寫百萬字固定多少錢”的保證。
長篇續寫:大窗口和可靠記憶是兩件事
短場景通過後,再用已有章節複核。把檢查點放在開頭、中間和接近當前章的不同位置,分別檢查人物身份、傷勢、物品、時間線和未公開資訊;讓續寫真的用到這些條件,而不只是問它能否複述。
材料超過實際輸入限制時,記錄你如何裁剪、摘要或選擇上下文。比較不同模型時,應先做同材料輸入的對照;再把各平臺提供的上下文管理作為另一個工作流實驗。不能一邊完整提供資料、一邊只給摘要,最後把差異全歸因給模型本身。
《Lost in the Middle》研究討論了被測語言模型對長上下文中不同位置的資訊使用差異。它不是2026年所有模型的排名,也不能替代你當前版本的複測。對創作而言,穩妥做法是保留設定表、近期事件和人物資訊邊界,並在換模型後重新檢查。
需要整理長篇材料時,可繼續看長篇創作框架和上下文裝配教程。這裡討論使用方法,不要求你為了選模型改造整套寫作系統。
在馬良裡怎麼開始,不用先換掉整本書的模型
先選一段有代表性的現有章節,保留原稿與設定,再打開當前功能的模型設定確認實際可用版本。只在這個片段上做對比,滿意後再決定是否擴展。不同寫作任務使用不同模型時,保留統一的角色口吻、視角和敘述要求。
還沒有大綱時,先用小說大綱模板明確人物目標、阻礙與章節變化;還沒有開始寫第一章,可接著看AI寫小說入門流程。這些材料準備不足時,直接更換更貴的模型未必解決問題。比較對白口吻時,可參考個人文風與角色聲音指南;處理複製產生的空行和標點時,可先用免費文本排版,但排版結果不能充當文筆評分。
常見問題
哪個AI寫小說最好?
本頁沒有足夠證據給出跨題材、跨版本的統一冠軍。對你最好的候選,應當在自己的同題測試中保留更多可採用內容,較少破壞設定,並滿足預算與等待時間要求。先做一個小範圍對比,再決定主力模型。
更大的上下文窗口,就能保證長篇不吃書嗎?
不能僅憑窗口規格作出保證。輸入容量、資料是否完整、資訊位置和生成時能否正確使用,分別需要檢查。用會影響當前劇情的設定測試,而不是隻問模型“記不記得”。
思考強度開到最高,正文一定更好嗎?
本頁不作這種保證。先固定參數建立基線,再單獨改變思考設定,比較實際輸出、等待和費用。不要同時更換模型、提示詞、材料和推理設定後,仍將結果當作單一變數實驗。
這份指南是否保證過審、簽約或檢測結果?
不保證。小說質量、平臺規則和檢測結果是不同問題;選型測試也不能證明文本由真人創作。投稿前應檢視目標平臺當時的正式規則。
本次修訂與來源
2026-09-06:保留原頁面地址和首次發佈時間,改為可複核的選型指南;提供原創測試題和教學正反例,撤下缺少可復算依據的舊評分、絕對記憶與固定百萬字成本結論。本次沒有開展新的付費模型橫評。
官方資料分別用於型號/價格核對與評測方法參考;實際產品支持以所用服務為準。正文中的故事、表格和成本算式是本指南的教學材料。發現具體事實錯誤,可以通過內容反饋說明頁面、原句及依據。