Escrever com IA: monte o contexto e economize tokens
Créditos caindo sem escrever quase nada? Causa da alta de tokens e 3 passos: estimativa, só nome e roteiros sob demanda.
Neste artigo 10 seções
Você só pediu à IA para continuar um trecho de dois mil caracteres, e os créditos caíram um bocado. O problema muitas vezes não está na «saída», e sim na «entrada»: antes de cada escrita, o sistema, por padrão, entrega à IA a arquitetura, as ambientações, os personagens e os fios de suspense do livro inteiro, e esse custo de «ler o material» é o verdadeiro culpado pela alta de tokens.
A boa notícia: essa parte é totalmente controlável. O «carregamento inteligente de contexto» do Maliang Writer deixa você decidir quanto material dar à IA a cada vez. Neste artigo, em três passos, ensinamos a gastar os créditos onde importa.
Pontos principais
- A alta de tokens vem principalmente do «lado da entrada»: a montagem integral do material do romance por padrão, e não a saída da IA.
- Carregamento inteligente de contexto = «montagem sob demanda» conforme o cenário, em vez de «enfiar tudo» a cada vez.
- Antes do envio, o Maliang Writer estima em tempo real os tokens dessa montagem e compara com o limite padrão de 60.000, avisando em vermelho.
- Três jeitos de economizar tokens: trocar «Completo» por «Só nome», abrir roteiros de capítulo e de volume só quando necessário e desligar as dimensões que não serão usadas.
Por que os tokens disparam?
Porque a cobrança dos grandes modelos é pelo total de «entrada + saída», e o material do romance no lado da entrada costuma ocupar muito mais espaço do que os poucos milhares de caracteres que você escreve. O conjunto de ambientações, personagens, suspense e arquitetura de um livro, somado, facilmente chega a dezenas de milhares de tokens, consumidos de novo a cada capítulo escrito.
Muita gente tenta economizar olhando «quantos caracteres a IA escreveu», e o rumo está errado. O grosso está em «quanto material a IA lê a cada vez». Quanto mais completo o material, menos a IA sai do rumo, mas maior o custo de cada geração: é uma balança que você precisa pesar de forma ativa.
Observação em teste: nos nossos testes internos, trocar ambientações e personagens de «Completo» para «Só nome» costuma reduzir de forma visível os tokens de contexto de cada escrita, com quase nenhum impacto perceptível na qualidade dos capítulos do dia a dia. A chave para economizar é distinguir «qual material a IA realmente consegue usar agora».
Para entender a estrutura geral de custos da escrita com IA, consulte Maliang Writer: versão gratuita vs paga.
O que é o «carregamento inteligente de contexto»?
O carregamento inteligente de contexto põe nas suas mãos a chave de «quanto material dar à IA», dando a quantidade conforme o cenário, em vez de abrir tudo sem pensar a cada vez. O oposto é o «enfiar tudo»: não importa o que se escreva, manda-se o material do livro inteiro de uma vez.
A ideia central é simples: ao escrever capítulos do dia a dia, basta a IA saber «quais personagens e ambientações existem», pois os detalhes ela consulta sob demanda; só nas viradas-chave é que o material completo é necessário como garantia. O carregamento inteligente permite dar, para cada cenário, a quantidade de informação que basta.
Perspectiva exclusiva: economizar tokens não é «dar pouco material e deixar a IA burra». Pelo contrário: quando se dá demais, a informação-chave fica afogada e a IA não capta o essencial. Dar com precisão «sob demanda» economiza e muitas vezes escreve de forma mais focada.
A entrada fica na barra do assistente de IA: clique na engrenagem «Gerenciamento de recursos de IA» e vá à aba «Contexto». Explicação completa no tutorial de montagem de contexto.
Passo 1: primeiro, entender a estimativa de tokens em tempo real
A condição para economizar é primeiro poder «ver» o gasto. O Maliang Writer estima em tempo real, antes do envio, quantos tokens essa montagem deve consumir. Sem esperar descontar os créditos para se arrepender.
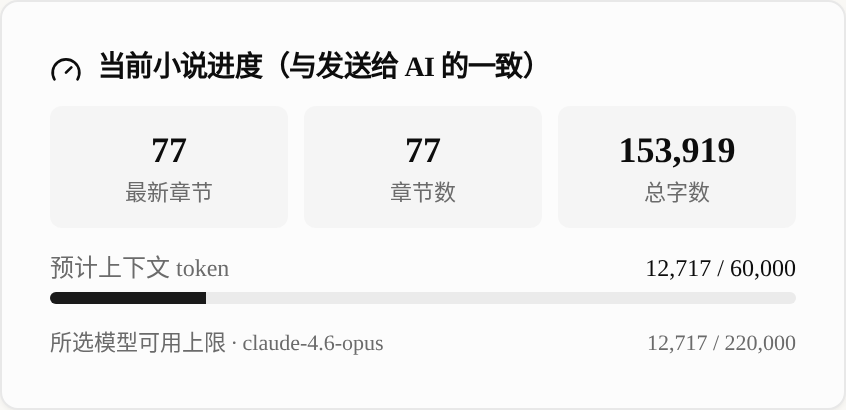
No topo do painel há uma barra de progresso «Tokens de contexto previstos», seguida do limite padrão de 60.000. Ela contabiliza em tempo real o custo da montagem atual, e ficando vermelha significa que é hora de enxugar. Mais abaixo há ainda uma linha «Limite disponível do modelo escolhido», que traz o nome do modelo de geração que você selecionou: alguns modelos têm janela pequena, e aqui você é avisado de antemão de que «esta montagem não cabe nele».
Guarde uma regra simples: a barra de cima compara com o «limite padrão da plataforma», e a linha de baixo compara com «se o modelo que você escolheu comporta». Se nenhuma das duas fica vermelha, pode enviar tranquilo.
Passo 2: trocar «Completo» por «Só nome»
Este é o jeito de economizar tokens com efeito mais imediato. Role até «Dimensões de montagem»: ambientações, personagens e suspense têm, cada um, dois níveis: «Completo» e «Só nome».
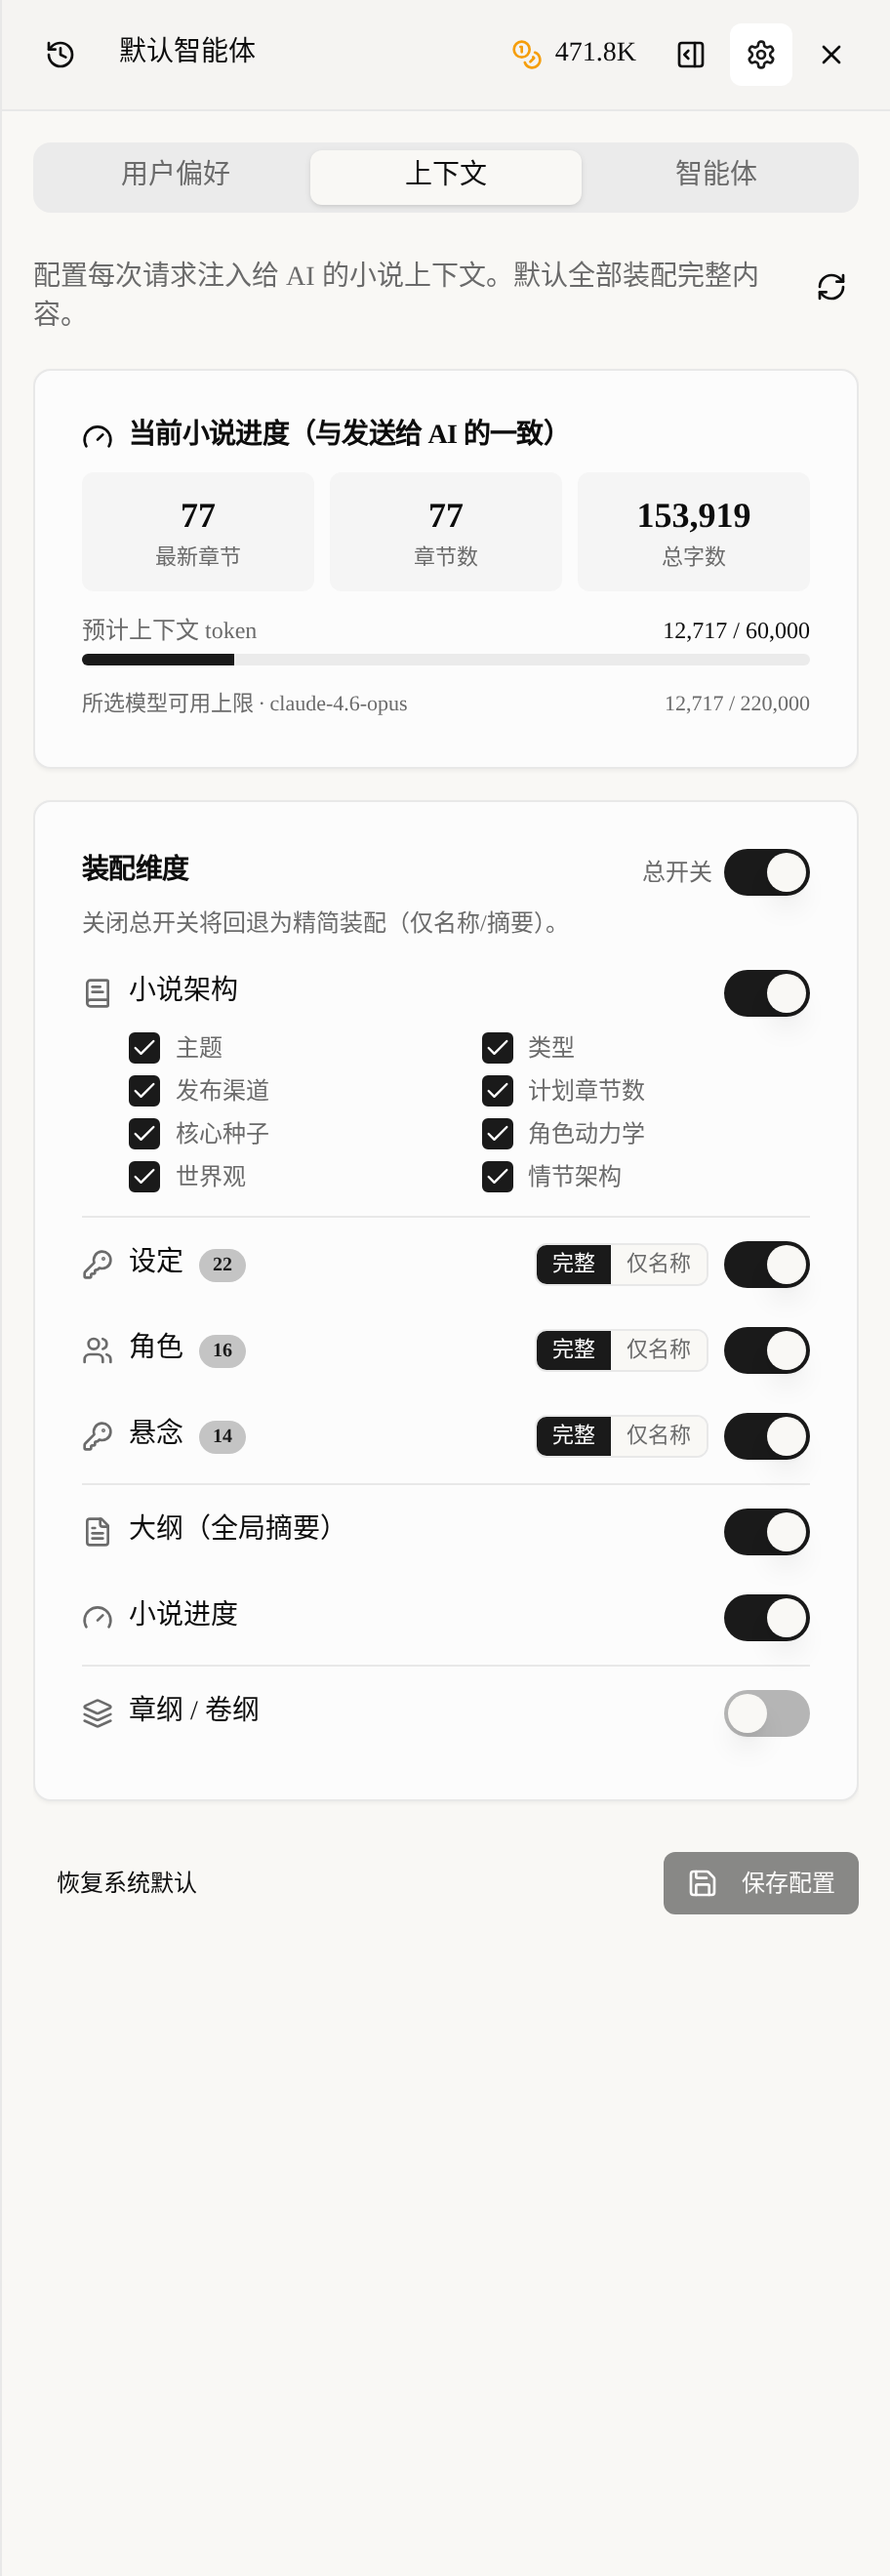
«Completo» entrega todo o material à IA; «Só nome» entrega apenas a lista de nomes, para a IA saber que «essas coisas existem», sem detalhá-las. Ao escrever texto em lote no dia a dia, use «Só nome» para ambientações e personagens: a IA continua reconhecendo as pessoas e não sai do rumo, e os tokens economizados são um bom bocado.
O pequeno número depois de cada item (por exemplo «Ambientações 22», «Personagens 16») é a quantidade atual de entradas do livro, para você julgar se «colocar tudo vai ser demais». No canto superior direito há ainda uma «chave geral»: desligando-a, volta-se à «montagem enxuta», a mais econômica, bem adequada para conversar só sobre ideias.
Passo 3: roteiros de capítulo e de volume só quando necessário, sem montar tudo por padrão
Os roteiros de capítulo e de volume são grandes consumidores de tokens e vêm desligados por padrão; ligados, fazem a IA seguir o roteiro à risca, mas o custo sobe de forma evidente. Por isso são «ligar sob demanda», não «sempre ligados».
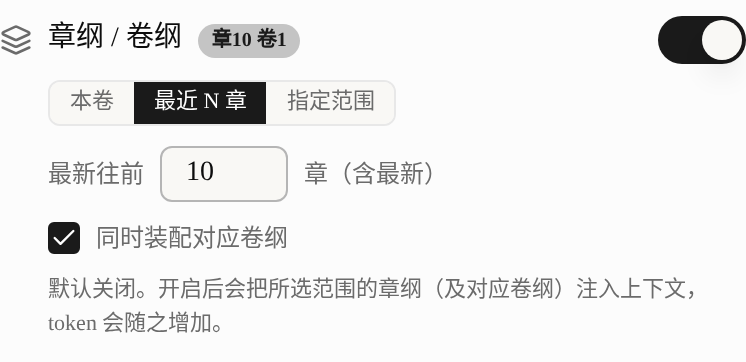
Há três alcances de montagem: «Este volume» dá só o roteiro dos capítulos do volume atual; «Últimos N capítulos» conta N capítulos a partir do mais recente; «Intervalo definido» permite preencher à mão um intervalo de capítulos. Mais abaixo há a opção «Montar também o roteiro do volume correspondente». O pequeno selo ao lado do botão informa quantos roteiros de capítulo e de volume foram realmente montados desta vez.
Lembrete de economia: ao expandir ou escrever capítulos de transição, os roteiros de capítulo e de volume podem ser desligados direto; ligue só nos capítulos-chave em que a IA precisa «seguir o roteiro à risca», dando preferência a «Este volume» ou «Últimos N capítulos», sem montar o livro inteiro à toa.
Três proporções práticas para economizar tokens
Não precisa ajustar do zero toda vez: aplique as três combinações abaixo conforme o cenário. São os três níveis que mais usamos:
| Cenário | Ambientações / personagens | Suspense | Roteiro de capítulo e volume | Uso |
|---|---|---|---|---|
| Texto em lote (mais econômico) | Só nome | Desligado | Este volume | Capítulos do dia a dia, de transição |
| Capítulos-chave (segurança) | Completo | Completo | Últimos N capítulos + roteiro do volume | Clímax, viradas, revelações |
| Só conversar ideias (mais leve) | Chave geral desligada | Desligado | Desligado | Brainstorming, inspiração em conversa |
Depois de alterar, não esqueça de clicar em «Salvar configuração», no rodapé: a configuração é salva por romance, definida uma vez por livro e válida por muito tempo.
Dica exclusiva: a maioria dos capítulos é, na verdade, do «dia a dia», e os capítulos de destaque que realmente exigem «Completo» são poucos. Deixe a proporção padrão no «mais econômico» e só suba temporariamente ao escrever capítulos-chave; a longo prazo, os créditos economizados são bem consideráveis.
O que acontece se os tokens passarem do limite? O mecanismo de proteção
Se a sua montagem empurra os tokens previstos acima do limite padrão, o sistema se protege de forma ativa, em vez de descontar em silêncio. A barra de progresso fica vermelha e aparece um aviso para você ligar o «Contexto máximo» nas configurações do chat.
Sem ligar o «Contexto máximo», o excedente é comprimido automaticamente e a IA pode «não ver tudo»; a qualidade do que ela escreve cai. Da mesma forma, se passar do «limite disponível do modelo escolhido», a linha de baixo também fica vermelha.
Diante do vermelho, há duas saídas: enxugar as dimensões conforme as proporções acima (a mais econômica costuma derrubar o valor na hora) ou trocar por um modelo de contexto maior. Para escolher o modelo, veja o guia de escolha de modelos de IA.
Como economizar ainda mais? Dois truques avançados
O primeiro truque é usar a visibilidade para «aliviar» o contexto. Defina como «Ocultar da IA» ou «Liberação progressiva por volume» as ambientações que não serão usadas em breve e as pistas plantadas que ainda não chegaram ao volume da revelação: elas não entram no contexto. Assim, mesmo com «ambientações completas» ligado, o que é realmente montado é só «a parte que deve ser dada agora», economizando e evitando spoiler. Detalhes em Revelação progressiva e visibilidade das ambientações.
O segundo truque é escolher o modelo certo. Para a mesma tarefa, o preço unitário e a janela de contexto variam muito entre modelos. Usar um modelo de bom custo-benefício nos capítulos do dia a dia e trocar para um de nível alto nos capítulos-chave é uma combinação mais econômica.
Lembrete prático: economizar tokens é um «conjunto de golpes»: a montagem inteligente reduz o volume de entrada, a visibilidade corta as entradas que não deveriam ser dadas e a escolha do modelo otimiza o preço unitário. Os três juntos funcionam melhor do que comprimir qualquer um isoladamente. Coloque isso no seu framework de criação de obras longas e o custo da obra longa fica realmente sob controle.
Perguntas frequentes
P: Economizar tokens faz a IA escrever pior?
Não, desde que seja «dar sob demanda» e não «cortar a esmo». Nos capítulos do dia a dia, com «Só nome» a IA sabe quais pessoas e ambientações existem e consulta os detalhes sob demanda; só nas viradas-chave é preciso «Completo». Dar demais afoga o essencial, e dar na medida muitas vezes escreve de forma mais focada.
P: O limite padrão de 60.000 tokens pode ser alterado? Se passar, é obrigatório ligar o «Contexto máximo»?
60.000 é o limite padrão da plataforma. Passando dele sem ligar o «Contexto máximo», o excedente é comprimido automaticamente e a IA pode não ver tudo; ligando, o sistema monta o máximo possível conforme a janela do modelo escolhido. Recomendamos primeiro baixar a estimativa para dentro do limite com a proporção mais econômica e só ligar o contexto grande se for realmente necessário.
P: Como saber quantos tokens foram gastos desta vez?
Veja a barra de progresso «Tokens de contexto previstos» no topo do painel: ela estima em tempo real, antes do envio, e compara com o limite padrão. A linha «Limite disponível do modelo escolhido», logo abaixo, informa também se o modelo atual comporta. Se nenhuma das duas fica vermelha, pode enviar tranquilo.
P: Os roteiros de capítulo e de volume devem ser ligados?
Sob demanda. Eles fazem a IA seguir o roteiro à risca, mas consomem muitos tokens. Ao expandir ou nos capítulos de transição, desligue direto; ligue só nos capítulos-chave, dando preferência a «Este volume» ou «Últimos N capítulos», sem montar o livro inteiro.
P: A configuração é global ou por livro?
Por romance. A proporção de economia que você definir para um livro vale só para ele, e ao trocar de livro é preciso configurar de novo. Depois de alterar, lembre-se de clicar em «Salvar configuração»; senão, na próxima vez que entrar, voltará à montagem integral padrão.
Para encerrar
Nos créditos da escrita com IA, o grosso é gasto em «ler material», e quanto material ler está nas suas mãos. Entender a estimativa de tokens, trocar «Completo» por «Só nome» e ligar roteiros de capítulo e de volume sob demanda: três passos já derrubam bastante o custo.
Somando o alívio pela visibilidade e a escolha do modelo certo, economizar tokens vira um conjunto de golpes reutilizável. Vá agora ao tutorial de montagem de contexto e defina a proporção padrão conforme o seu ritmo de escrita, para que cada crédito seja gasto onde realmente se precisa.