AI小説のトークン急増とクレジットの浪費を、コンテキスト装配で抑える完全ガイド
少し書いただけでクレジットが急減?トークン急増と節約3法(リアルタイム見積、「完全」から「名前のみ」へ、章・巻プロットは必要時のみ)、配分3例と上限保護も解説。
この記事の目次 10セクション
AIに2000字ほど続きを書かせただけなのに、クレジットがごっそり減った。問題は「出力」ではなく、「入力」にあることがよくあります——執筆の前に毎回、システムが既定で、作品全体の構造、設定、キャラクター、サスペンスをまとめてAIに渡しており、この「資料を読む」分の消費が、トークン急増の真犯人です。
よい知らせは、この部分は完全に制御できることです。Maliang Writerの「賢いコンテキスト読み込み」では、毎回AIにどれだけ資料を渡すかを自分で決められます。この記事では3ステップで、クレジットを要所に使う方法を教えます。
要点
- トークン急増の主な原因は「入力側」——既定で小説の資料を全量で装配することで、AIの出力ではない。
- 賢いコンテキスト読み込み=場面に応じた「必要に応じた装配」で、毎回の「全量の詰め込み」ではない。
- Maliang Writerは送信前に、この装配のトークンをリアルタイムで見積もり、既定の上限60,000と比較し、赤くなったら知らせる。
- 節約の3つの手:「完全」を「名前のみ」に変える、章プロット・巻プロットを必要なときだけオンにする、使わない項目をオフにする。
なぜトークンは急増するのか?
大規模モデルの課金は「入力+出力」の合計で計算され、入力側の小説の資料は、あなたが書く数千字よりずっと場所を取ることが多いからです。 1作品分の設定、キャラクター、サスペンス、構造を合わせると、あっさり数万トークンになり、1章書くたびに1回ずつ繰り返し消費されます。
多くの人は「AIが何字書いたか」に注目して節約しようとしますが、方向が間違っています。本当に大きいのは、「AIが毎回どれだけの資料を読んだか」です。資料を多く与えるほど、AIは脇道にそれませんが、生成1回あたりのコストも高くなります——これは、あなたが自分から見極める必要のある天秤です。
実測の観察: 当方の社内テストでは、設定とキャラクターを「完全」から「名前のみ」に変えると、1回の執筆のコンテキストトークンは、通常はっきりと下がり、日常の章の執筆品質にはほとんど感じ取れる影響がありません。節約の鍵は、「どの資料を、AIが今本当に使えるか」を見分けることです。
AI執筆全体のコスト構造を理解するには、Maliang Writerの無料版と有料版を参考にしてください。
「賢いコンテキスト読み込み」とは?
賢いコンテキスト読み込みとは、「AIにどれだけ資料を渡すか」のスイッチをあなたの手に渡し、場面に応じて量を与えるもので、毎回無頓着にすべてオンにしないことです。 その反対は「全量の詰め込み」——何を書くときでも、作品全体の資料をまとめて送ってしまうことです。
核心の考え方は素朴です。AIが日常の章を書くときは、「どんなキャラクターがいて、どんな設定が存在するか」を知っていれば十分で、細部は必要に応じてAIが尋ねます。重要な転換を書くときだけ、完全な資料が下支えとして必要です。賢い読み込みは、場面ごとに、ちょうど足りる情報量を与えられるようにするものです。
独自の視点: トークンの節約は、「資料が少なくてAIが愚かになる」ことと同じではありません。むしろ逆で——与えすぎると、肝心な情報がかえって埋もれ、AIは要点をつかめません。正確に「必要に応じて与える」ほうが、節約になり、しばしばより焦点の絞られた文章になります。
入口は、AIアシスタントのパネルで歯車の「AI機能管理」をクリックし、「コンテキスト」タブに切り替えることです。完全な説明はコンテキスト装配のチュートリアルを見てください。
ステップ1:まずリアルタイムのトークン見積もりを読み解く
節約の前提は、まず費用が「見える」ことです。Maliang Writerは、あなたが送信する前に、この装配にどのくらいのトークンがかかるかをリアルタイムで見積もります。 クレジットが引かれてから後悔するのを待つ必要はありません。
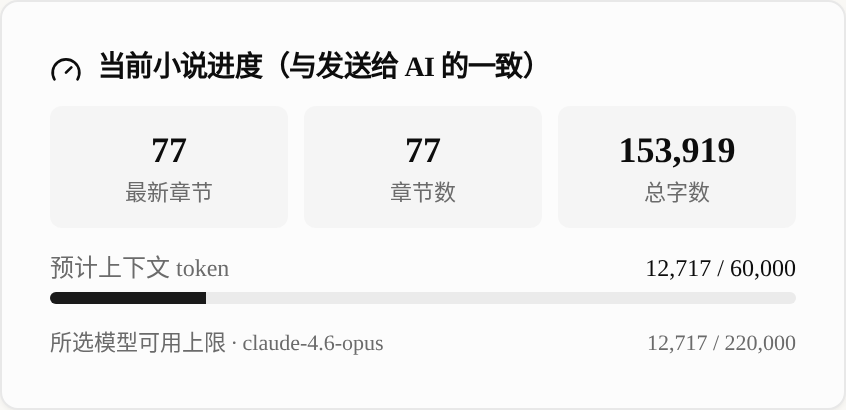
パネル上部に「推定コンテキストトークン」の進捗バーがあり、その後ろに既定の上限60,000が続きます。現在の装配の消費をリアルタイムで集計し、赤くなったら絞り込むべきだということです。さらに下には「選択したモデルの上限」の行があり、現在選んでいる生成モデルの名前が付きます——モデルによってはウィンドウが小さく、ここで「この装配は入りきらない」と事前に教えてくれます。
簡単な覚え方:上のバーが比べているのは「プラットフォームの既定の上限」で、下の行が比べているのは「選んだモデルに入りきるかどうか」です。どちらも赤くならなければ、安心して送信できます。
ステップ2:「完全」を「名前のみ」に替える
これが、トークン節約でいちばん即効性のある手です。 「装配項目」までスクロールすると、設定、キャラクター、サスペンスの各項目に、「完全」と「名前のみ」の2段階があります。
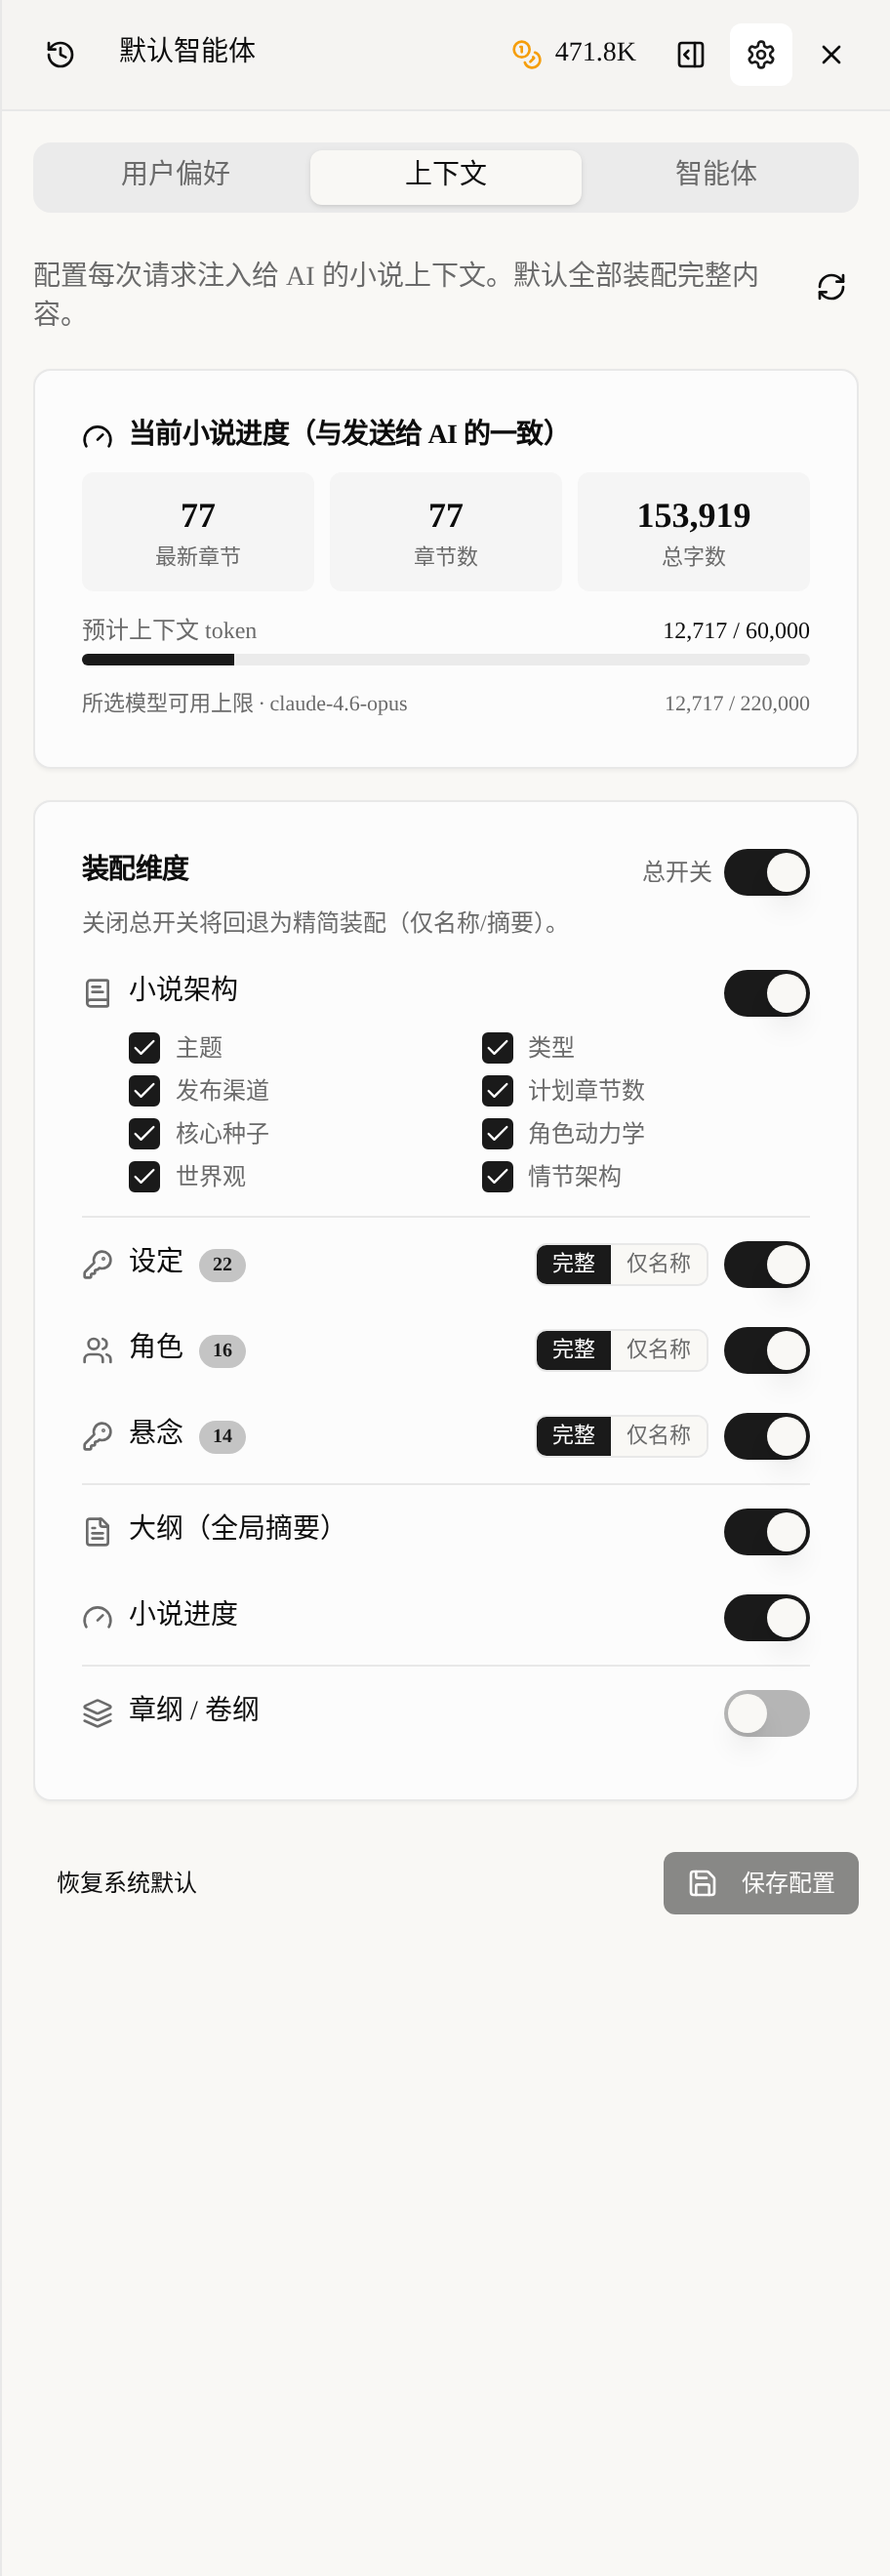
「完全」は資料のすべてをAIに渡し、「名前のみ」は名前のリストだけを渡して、AIに「これらが存在する」とだけ知らせ、細部は展開しません。日常の本文を一括で書くときは、設定とキャラクターを「名前のみ」にしても、AIは変わらず人物を認識して脇道にそれず、トークンは大きく節約できます。
各項目の後ろの小さな数字(たとえば「設定 22」「キャラクター 16」)は、この作品の現在の項目数で、「全部入れると多すぎないか」を判断する助けになります。右上には「マスタースイッチ」もあり、オフにすると最も節約的な「簡易装配」に戻り、純粋にアイデアを話すときに適しています。
ステップ3:章プロット・巻プロットは必要なときだけオンにし、既定で全部装配しない
章プロット・巻プロットはトークンの大食いで、既定ではオフです。オンにするとAIに厳密にプロットどおりに書かせられますが、消費は目に見えて増えます。 だから「必要に応じてオン」で、「常にオン」ではありません。
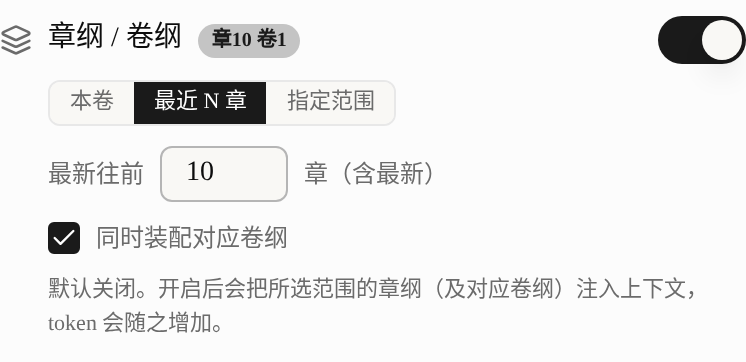
装配範囲には3種類あります。「今の巻」は現在のこの1巻の章プロットだけを渡し、「直近N章」は最新から遡ってN章、「指定範囲」は章の区間を手動で入力します。その下には「対応する巻プロットも同時に装配」のチェックもあります。スイッチの横の小さなバッジが、今回実際に章プロットと巻プロットをいくつ装配したかを教えてくれます。
節約のリマインド: 普段の膨らませ書きやつなぎの章では、章プロット・巻プロットはそのままオフにしてかまいません。「AIにプロットを厳密に踏ませる」重要な章でだけオンにし、その場合も「今の巻」か「直近N章」を優先し、むやみに作品全体を装配しないでください。
トークン節約の3つの実践配分
毎回ゼロから調整する必要はなく、場面に応じて次の3つの組み合わせを当てはめれば済みます。 これが、私たちが最もよく使う3段階です。
| 場面 | 設定/キャラクター | サスペンス | 章プロット・巻プロット | 適用 |
|---|---|---|---|---|
| 本文の大量執筆(最も節約) | 名前のみ | オフ | 今の巻 | 日常の章、つなぎの章 |
| 重要な章(安定重視) | 完全 | 完全 | 直近N章+巻プロット | クライマックス、転換、種明かし |
| 純粋にアイデアを話す(最も軽い) | マスタースイッチをオフ | オフ | オフ | ブレインストーミング、会話でのひらめき |
変更したら、下部の「設定を保存」をクリックするのを忘れないでください——設定は作品ごとに別々に保存され、1作品に1回設定すれば長期的に有効です。
独自の心得: ほとんどの章は実は「日常」に属し、本当に「完全」が必要な見せ場の章の割合は高くありません。既定の配分を「最も節約」にしておき、重要な章を書くときだけ一時的に引き上げれば、長い目で見て節約できるクレジットはかなりのものになります。
トークンが上限を超えるとどうなる? 超過の保護の仕組み
装配によって推定トークンが既定の上限を超えた場合、システムは黙ってお金を引くのではなく、積極的に保護します。 進捗バーが赤くなり、チャット設定で「最大コンテキスト」をオンにするよう促すメッセージが表示されます。
「最大コンテキスト」をオンにしない場合、超えた部分は自動で圧縮され、AIは「全体を見られない」かもしれません——そのとき、書かれる文章の品質は割り引かれます。同様に、「選択したモデルの上限」を超えた場合も、下の行が赤くなります。
赤くなったときの対処は2つです。上の配分に従って項目を絞り込むか(最も節約的な配分なら、たいていすぐに下がります)、コンテキストのより大きいモデルに替えるかです。モデルの選び方は、AIモデルの選び方ガイドを見てください。
ほかにどう節約できるか? 2つの応用の手
1つめの手は、可視性でコンテキストの「負担を減らす」ことです。 短期的には使わない設定や、まだ種明かしの巻に達していない伏線を、「AIに非表示」または「巻ごとに段階的に公開」に設定すれば、コンテキストに入りません。こうすれば、「設定を完全」にオンにしていても、実際に装配されるのは「今渡すべき部分」だけになり、節約になり、ネタバレも防げます。具体的には段階的開示と設定の可視性を見てください。
2つめの手は、適切なモデルを選ぶことです。 同じタスクでも、モデルごとに単価とコンテキストウィンドウは大きく違います。日常の章にはコストパフォーマンスの高いモデルを使い、重要な章でだけ上位のモデルに切り替えるのが、より経済的な組み合わせです。
実践のリマインド: トークンの節約は「コンボ」です。賢い装配で入力量を減らし、可視性で渡すべきでない項目を削り、モデル選びで単価を最適化します。3つの手を重ねるほうが、どれか1つだけを圧縮するよりも効果的です。これを長編創作フレームワークに組み込めば、長編のコストを本当に制御できます。
よくある質問
Q:トークンを節約すると、AIの書く内容が悪くなりませんか?
なりません。ただし、「必要に応じて渡す」ことが前提で、「やみくもに削る」ことではありません。日常の章は「名前のみ」で、AIはどんな人物と設定があるかを知っていれば十分で、細部は必要に応じて呼び出されます。重要な転換を書くときだけ「完全」が必要です。与えすぎると、かえって要点が埋もれ、正確に量を与えるほうが、しばしばより焦点の絞られた文章になります。
Q:既定の上限60,000トークンは変更できますか? 超えたら、必ず「最大コンテキスト」をオンにする必要がありますか?
60,000はプラットフォームの既定の上限です。超えても「最大コンテキスト」をオンにしなければ、超えた部分は自動で圧縮され、AIが全体を見られないことがあります。オンにすれば、選んだモデルのウィンドウに合わせて、できるだけ入れます。まず最も節約的な配分で見積もりを上限内に収め、どうしても大きなコンテキストが必要なときにオンにすることをお勧めします。
Q:今回、結局どのくらいのトークンを使ったのか、どうやって知りますか?
パネル上部の「推定コンテキストトークン」の進捗バーを見てください。送信前にリアルタイムで見積もり、既定の上限と比較します。下の「選択したモデルの上限」の行は、現在のモデルに入りきるかも教えてくれます。どちらも赤くならなければ、安心して送信できます。
Q:章プロット・巻プロットは、結局オンにすべきですか?
必要に応じてオンにします。AIにプロットを厳密に踏ませられますが、トークンの大食いです。普段の膨らませ書きやつなぎの章はそのままオフにし、重要な章でだけオンにして、その場合も「今の巻」か「直近N章」を優先し、作品全体を装配しないでください。
Q:設定は全体共通ですか、作品ごとですか?
作品ごとに別々に保存されます。ある作品に設定したトークン節約の配分は、その作品にだけ作用し、別の作品に替えれば設定し直します。変更したら「設定を保存」をクリックするのを忘れないでください。そうしないと、次に入ったときにまた既定の全量装配に戻ります。
最後に
AI執筆のクレジットは、大部分が「資料を読む」ことに使われ、どれだけの資料を読ませるかの主導権は、あなたの手にあります。トークンの見積もりを読み解き、「完全」を「名前のみ」に替え、章プロット・巻プロットを必要に応じてオンにする——3ステップで、コストを大きく抑えられます。
さらに可視性による負担軽減とモデル選びを重ねれば、トークンの節約は、再利用できるコンボになります。今すぐコンテキスト装配のチュートリアルを見て、あなたの執筆のペースに合わせた既定の配分を設定し、1クレジットも、本当に必要なところに使いましょう。