2026年 小説向けAIモデルの選び方|Claude・Gemini・GPT・DeepSeek
小説に使うAIは、総合ランキングではなくジャンルとタスクで比べます。公式の確認先、オリジナルの同一課題テスト、コピーできる採点表、再試行と手直しを含むコストの計算方法を示します。
この記事の目次 10セクション
小説に使うAIモデルは? まずタスクで選ぶ
毎日の本文なら、手直しが最も少なく、総コストが許容できるモデルを。ミステリーや群像劇なら、まず因果、人物像、情報の境界を見る。長編の続きなら、既存の設定と章で実測する必要があり、コンテキストウィンドウを記憶の保証とみなしてはいけません。 Claude、Gemini、GPT、DeepSeekのどれも候補に入れられますが、ブランド名は具体的なバージョンではなく、同じバージョンでもプラットフォームによって、パラメーター、上限、料金が同じとは限りません。
初めての選定では、10個のモデルを同時に試す必要はありません。普通に使える2つのバージョンを選び、下の同じ物語の資料で、プロット、会話、改稿をそれぞれ行い、名前を隠して比べます。結果が近いときは、根拠のない「文章力ナンバーワン」を追うよりも、より安定していて手直しの負担が小さいほうを優先します。
このページが示す証拠の範囲:これは選定と自己テストのためのガイドであり、新たなモデルのランキングではありません。2026-09-06の改訂時点で、旧版のスコア、百万字あたりのコスト試算、「最初の100章を完全に記憶する」といった記述には、読者が再計算できる十分な証拠がなかったため、ランキングの結論としては扱いません。以下の物語や良い例・悪い例は、確認の方法を説明するために作った教材であり、どのモデルの実測の出力でもありません。公式リンクは製品と評価方法の確認用で、特定のモデルの小説の文章力が優れていることを示すものではありません。
まず候補を絞る:いちばんつまずくのはどの工程か
| 創作のタスク | まず何を比べるか | どんな現象なら不向きと判断するか | 通過後に何を比べるか |
|---|---|---|---|
| 毎日本文を書き続ける | 同じジャンルで残せる段落、重複する表現、安定性 | 章ごとに語り口を書き直す必要がある、またはよく途中で切れる | 実際の課金、最初の段落までの待ち時間、手直しの時間 |
| キャラクターの会話と恋愛シーン | 1人ひとりの話し方に動機と違いがあるか | 全員が同じ口調で、地の文で感情を説明している | テンポ、言外の意味、あなた個人の好み |
| ミステリー、群像劇、伏線 | 誰が何を知っているか、証拠の順序、因果の連鎖 | 真相を先に漏らす、キャラクターがまだ得ていない手がかりを使う | 表現の自然さ、手直しのコスト |
| 長編の続き | 重要な設定を、必要なときに正しく使えるか | 怪我、持ち物の持ち主、時間、人物関係を忘れる | 入力コスト、コンテキストの整理、応答時間 |
| プロットと改稿 | 提案が具体的か、あなたの示した目標に合っているか | 「対立を増やす」としか言わず、出来事と代償を示さない | 案の違い、実行可能性、費用 |
この表は選ぶ順序であって、ベンダーのブランドランキングではありません。恋愛を書く作者とハードSFを書く作者では、異なる結果が出ます。同じ作者でも、計画、本文、チェックにそれぞれ別のモデルを選ぶことはできますが、モデルを替えたあとの語りのスタイルの断絶に注意が必要です。
Claude、Gemini、GPT、DeepSeek:まずバージョンを確認してから比べる
| 候補のモデルファミリー | 使う前に確認すること | 小説テストの重点 | 公式情報の入口 |
|---|---|---|---|
| Claude | 正確なモデルID、思考の設定、入力と出力の制限 | 会話の動機、語り口、修正意見に沿った書き直し | モデル一覧、料金 |
| Gemini | 安定版かプレビュー版か、実際のエンドポイント、コンテキストと出力の制限 | 複数章の資料の引用、設定の漏れ、画像つき資料のタスク | モデル一覧、料金 |
| GPT | 具体的なバージョン、推論の設定、チャット製品かAPIか | プロットの因果、制約の遵守、証拠に基づく改稿 | モデル一覧、料金 |
| DeepSeek | 実際のモデルのバージョン、思考モード、キャッシュと出力の課金の基準 | 中国語のジャンルでの表現、人物の一貫性、本文の手直しの量 | モデルと料金 |
「テストの重点」は、このガイドが確認を勧める観点であり、ほかのモデルにその能力がないと断言するものではありません。プラットフォームが「高性能モデル」や「スマートモード」としか表示していないときは、見えている段階をまず記録し、自分でその裏にあるモデルIDを勝手に付けないでください。
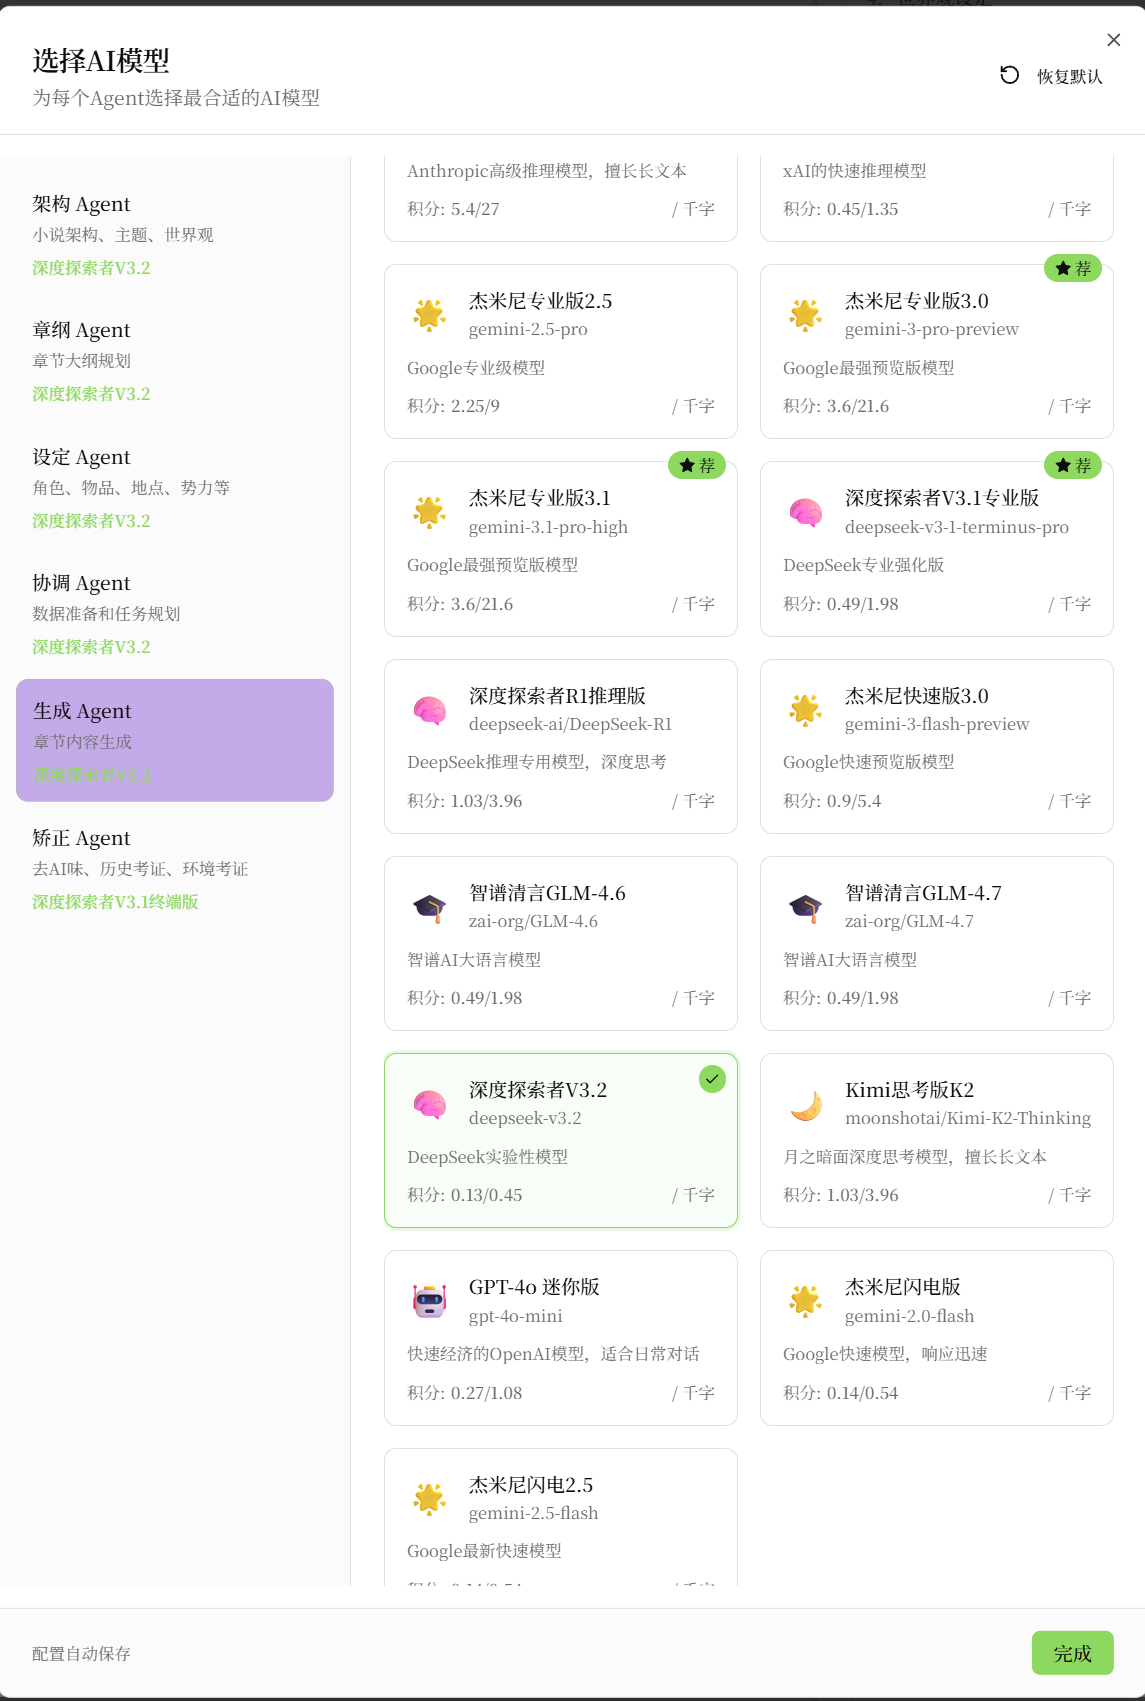
公式APIの定価は、チャット製品のサブスクリプション料金と同じではなく、Maliang Writerのクレジットの価格とも同じではありません。サイト内であるバージョンを提供しているかどうかは、現在の機能のモデル選択画面を基準にしてください。紹介記事を書いたからといって、そのバージョンがすでに接続されているとは限りません。Maliang Writerの料金と期間は料金とプラン、機能の入口はマルチモデル設定の説明を見てください。
同一課題テスト:同じ物語の資料で、3種類のタスクを行う
完全な同一課題の試用パックと空白の記録表を保存する。資料はこのページと同じ課題の出典を共有しており、ファイルには記入済みの成績はなく、登録も不要です。
以下はこのガイドのオリジナルの練習用資料で、個人の選定に使えます。使う権利のある作品の短い一節に置き換えても構いません。許可のない他人の原稿や、個人情報を含む資料はアップロードしないでください。各候補に対して、まったく同じ設定、タスク、出力の長さの要件を使います。
固定する物語の設定
物語:雨夜の渡し場

人物と事実:
1. 祁岸は傘の修理屋で、右手首を怪我しており、右手では重い物を持てない。
2. 陸遥は渡し場の帳簿係で、船の便を覚えているが、字が読めない。
3. 封を切っていない手紙が祁岸の上着の内ポケットにあり、それがそこにあることは祁岸だけが知っている。
4. 銅の鍵はすでに船頭に渡してあり、説明なしに祁岸の手に戻ってはならない。
5. 大鐘が3回目に鳴ったあと、最終の渡し船が岸を離れる。
6. この場面では祁岸の限定視点だけを使い、陸遥の内心を直接書いてはならない。

目前の目標:
祁岸は、船が出る前に陸遥が嘘をついているかを確かめたいが、手紙の存在は明かしたくない。
陸遥は祁岸に残ってほしいが、直接の告白では対立を解決できない。

結末の方向:
双方の関係に小さな変化が1つ起き、次の章で確かめられる疑問を1つ残し、
この場面では手紙の内容を明かさない。
タスク1:プロットに因果があるか。きれいな見出しが6つ並んでいるだけではないか
固定した設定に基づいて、連続する6つのプロットポイントを書いてください。
各ポイントに、誰が行動するか、行動にどんな代償を払うか、どんな変化が生じるかを書くこと。
全体の長さは300〜450字(空白を除く)に収めること。
対立を直接解決できる新しい人物や新しい小道具を増やしてはならない。
プロットを出力し、本文は書かないこと。
各転換が前のステップから導かれているかを確認します。人名を隠しても、6つのポイントがどんな物語にも当てはまるなら、通常は、案がまだ具体的でないということです。
タスク2:会話が2人の異なる目的を表せているか
固定した設定に基づいて、500〜700字(空白を除く)の場面を書いてください。
会話は少なくとも4往復し、会話と動作を織り交ぜ、人物のラベルだけを単独で並べないこと。
祁岸の限定視点を保ち、陸遥が内心で何を考えているかを直接説明してはならない。
2人はそれぞれ相手の決断を変えようとし、結末で直接和解してはならない。
本文のみを出力すること。
「名言があるか」だけを評価しないでください。印を付ける価値があるのは、どの台詞が探りを入れているか、どの動作が回避しているか、言い終えたあとに状況が変わったかです。
タスク3:修正意見を受けて、直すよう言っていない部分を壊さないか
各モデルについて、それぞれタスク2での完全な出力を使い、同じ修正意見を添えます。
既存の事実、持ち物の持ち主、時間の順序、人物関係を保つこと。
説明的な心理のまとめを削り、最後の疑問を、目に見える動作で示すこと。
元の視点を保ち、手紙を明かさず、人物を増やさないこと。
修正後の場面全体を出力し、そのあとに3項目以内の修正の説明を別に書くこと。
この段階で評価するのは「それぞれの初稿からそれぞれの改稿まで」の一連のワークフローであり、同じ入力での純粋な書き換えの比較ではありません。書き換えの能力だけを別に比べたいときは、同じ固定済みの初稿を別に用意してすべてのモデルに渡し、2つの実験の結果を混ぜて平均しないでください。
少数サンプルでの使い方:各モデルで3つのタスクを2回ずつ行います。2つのモデルで合計12件のタスクの出力が得られます。毎回、新しいまっさらなセッションを使い、タスク3は、その回のタスク2の初稿を引き継ぎます。毎回の結果と失敗を残し、最もよいものだけを選ばないでください。同じ課題を繰り返し実行しても12個の独立した課題にはならず、すべてのジャンルを代表することもありません。一次選別のあと、自分の異なる章でも確認してください。
判断のしかた:まず厳守事項を確認し、それから文章を盲検で読む
まず、6つの固定された事実が破られていないかを記録します。きれいな言い回しで、「右手首を怪我しているのに右手で箱を運ぶ」「字が読めないのに手紙を直接読む」といった、位置を特定できる問題を覆い隠させないでください。
次の2つの段落は、確認の方法を説明するために作った教材としての良い例・悪い例であり、モデルのスコアではありません。
悪い例:祁岸は右手で木箱を持ち上げ、銅の鍵を机に叩きつけた。陸遥は彼の内ポケットの手紙の文字をはっきり読み取り、ようやく彼の来意を理解した。
これは、怪我の制約、鍵の持ち主、情報の境界を同時に破っており、さらに「字が読めない」はずの人物を、手紙を読める人物にしてしまっています。
修正例:祁岸は木箱を左足の脇へ押しやっただけで、手は伸ばさなかった。陸遥がもう一度船の便を尋ねたが、彼はそれより先に鐘楼を見た。3回目の音はまだ鳴っていない。
2つ目の段落は、既知の事実を壊さない方法を示すだけのもので、文学的に必ずしも優れているとは限りません。対立が十分か、言葉がジャンルに合っているかは、やはりあなたが判断する必要があります。
モデル名をAとBに置き換え、交互に読み、各項目について具体的な文を理由として残します。
| 確認項目 | 記録の方法 |
|---|---|
| 事実と視点 | 1項目ずつ、合格・不合格・判断不能に印を付け、原文を添える |
| 因果と情報の増分 | 何が変わったかを説明し、「流れがよい」といった評だけで済ませない |
| 人物の声 | この人物だけが言う台詞を1つ探す。見つからなければ、そのまま記録する |
| 改稿後の完全性 | 初稿と照らし、頼んでいないのに増やした・削った・壊した事実に印を付ける |
| 採用の度合い | 実際に残した段落と手直しの時間に印を付け、出力の長さを採用量とみなさない |
| 安定性 | 2回の差、途中での切れ、拒否、タイムアウトをそれぞれ記録する。1回よかったことは安定性の結論ではない |
盲検での評価に慣れていないときは、まずOpenAIの評価方法を見るとよいでしょう。実際のタスクに基づいて評価を設計し、主観的な印象だけにならないようにし、評価自体も検証します。この方法の参照は、OpenAIがこのページのモデル選定の結果を保証していることを意味しません。
小説にいくらかかるか:1回の生成ではなく「採用1,000字あたり」で計算する
少なくとも次の4つを分けて記録します。実際の入力費用、出力費用、課金された再試行の費用、人の手直しの時間です。中国語の文字数とトークン数を固定の比率で換算しないでください。異なる通貨を直接足し合わせることもしないでください。
採用1,000字あたりのモデル費用
= 同じ一連のタスクの実際のモデル費用の合計 ÷ 最終的に採用した文字数 × 1000

別に記録するもの:手直しの分数、最初の段落までの待ち時間(秒)、全体の完了時間。
採用した文字数が0の場合は「採用できる成果なし」と記録し、コスト0とは記録しない。
計算式の例であり、見積もりでも実測でもありません:初稿と再試行の合計で2元かかり、最終的に1,600字を採用したなら、モデル費用は採用1,000字あたり1.25元です。さらに30分手直ししたなら、その30分も判断に入れるべきです。1回あたりの呼び出しが安くても、使える章あたりのコストが安いとは限りません。
開発者が自分でAPIを呼び出す場合は、利用するサービスの請求書に基づいて、キャッシュヒット時の入力、キャッシュミス時の入力、出力とを区別する必要があります。詳細はClaudeの料金、Geminiの料金、GPTの料金、DeepSeekの料金を見てください。このガイドは、チャネルの見積もりを「百万字を書くのに固定でいくら」という保証に換算することはしません。
長編の続き:大きなウィンドウと信頼できる記憶は別のこと
短い場面に通ったら、既存の章で確認します。確認ポイントを、冒頭、中盤、現在の章に近い位置と、異なる場所に置き、人物の身分、怪我、持ち物、時間軸、まだ明かされていない情報を、それぞれ確認します。続きの執筆でこれらの条件を実際に使わせ、復唱できるかを尋ねるだけにはしないでください。
資料が実際の入力の上限を超えるときは、どう切り詰めたか、要約したか、コンテキストをどう選んだかを記録します。異なるモデルを比べるときは、まず同じ資料を入力する対照を行い、そのあとで、各プラットフォームが提供するコンテキストの管理を別のワークフローの実験として扱います。一方では資料を完全に渡し、もう一方では要約だけを渡して、最後に差をすべてモデル自体のせいにするわけにはいきません。
『Lost in the Middle』の研究は、評価対象の言語モデルが長いコンテキストの中の位置によって、情報の使い方が異なることを論じています。これは2026年のすべてのモデルのランキングではなく、あなたが今使っているバージョンの再テストの代わりにもなりません。創作では、設定表、直近の出来事、人物の情報の境界を残しておき、モデルを替えたあとに改めて確認するのが確実です。
長編の資料を整理する必要があるときは、長編創作のフレームワークとコンテキスト組み立てのチュートリアルも見てください。ここで論じているのは使い方であり、モデルを選ぶために執筆システム全体を作り替えることを求めてはいません。
Maliang Writerでの始め方:本全体のモデルを先に替えなくていい
まず、代表的な既存の章を1つ選び、原稿と設定を残したまま、現在の機能のモデル設定を開いて、実際に使えるバージョンを確認します。この断片だけで比較し、満足してから拡張するかどうかを決めます。タスクごとに異なるモデルを使うときは、統一したキャラクターの口調、視点、語りの要件を保ってください。
まだプロットがないときは、先に小説プロットのテンプレートで、人物の目標、障害、章ごとの変化を明確にします。まだ第1章を書き始めていないなら、AIで小説を書く入門の流れに進んでください。これらの資料の準備が足りないまま、より高いモデルに替えても、問題が解決するとは限りません。会話の口調を比べるときは、個人の文体とキャラクターの声のガイドを参考にでき、コピーで生じた空行や句読点を整えるときは、まず無料のテキスト整形を使えますが、整形の結果を文章力の採点にしてはいけません。
よくある質問
小説に最も向いているAIはどれですか?
このページには、ジャンルやバージョンをまたいだ統一の優勝者を示す十分な証拠がありません。あなたにとって最良の候補は、自分の同一課題テストで、より多くの採用できる内容を残し、設定を壊すことが少なく、予算と待ち時間の要件を満たすものです。まず小規模な比較を行ってから、主力のモデルを決めてください。
コンテキストウィンドウが大きければ、長編で設定矛盾が起きないと保証されますか?
ウィンドウの仕様だけでは保証できません。入力の容量、資料が完全か、情報の位置、生成時に正しく使えるかは、それぞれ確認が必要です。モデルに「覚えているか」と尋ねるだけでなく、現在の展開に影響する設定でテストしてください。
思考の強度を最高にすれば、本文は必ずよくなりますか?
このページはそのような保証をしません。まずパラメーターを固定して基準を作り、それから思考の設定だけを変えて、実際の出力、待ち時間、費用を比べます。モデル、プロンプト、資料、推論の設定を同時に替えておいて、その結果を単一の変数の実験とみなさないでください。
このガイドは、審査通過、契約、検出の結果を保証しますか?
保証しません。小説の質、プラットフォームの規則、検出の結果は別の問題です。選定テストは、文章が人間によって書かれたことの証明にもなりません。投稿の前に、投稿先のプラットフォームのそのときの正式な規則を確認してください。
今回の改訂と出典
2026-09-06:元のページのアドレスと初回の公開日を残したまま、検証できる選定ガイドに改め、オリジナルのテスト課題と教材としての良い例・悪い例を提供し、再計算の根拠が欠けていた旧版のスコア、絶対的な記憶、固定の百万字あたりのコストの結論を取り下げました。今回は、新たな有料モデルの横並び比較は行っていません。
公式資料は、それぞれモデル・料金の確認と評価方法の参考に使っています。実際の製品の対応は、利用するサービスを基準にしてください。本文の物語、表、コストの計算式は、このガイドの教材です。具体的な事実の誤りを見つけたら、コンテンツのフィードバックから、ページ、原文、根拠をお知らせください。