Токены взлетают, кредиты тают? Умная сборка контекста экономит токены
Кредиты тают, а текста нет? Причины скачка токенов и три шага экономии: оценка токенов, «Только названия», планы глав по необходимости. Три пропорции и защита от превышения.
Содержание 10 разделов
Вы просто попросили ИИ продолжить на две тысячи знаков, а кредитов ушло много. Проблема часто не в «выходе», а во «входе»: перед каждым письмом система по умолчанию отдаёт ИИ архитектуру всей книги, библию мира, персонажей, интригу, и именно эти расходы на «чтение материалов» — настоящий виновник скачка токенов.
Хорошая новость: эта часть полностью управляема. «Умная загрузка контекста» в Maliang Writer позволяет Вам самим решать, сколько материалов давать ИИ каждый раз. В этой статье — три шага, чтобы тратить кредиты по делу.
Главное
- Скачок токенов в основном идёт от «входа» — по умолчанию материалы романа собираются целиком, а не от вывода ИИ.
- Умная загрузка контекста = «сборка по необходимости» по сценарию, а не «засовывание всего» каждый раз.
- Перед отправкой Maliang Writer в реальном времени оценивает токены такой сборки и сравнивает с верхним пределом по умолчанию 60 000; покраснело — предупреждение.
- Три приёма экономии: «Полностью» → «Только названия», планы глав и томов по необходимости, отключить ненужные измерения.
Почему токены взлетают?
Потому что тарификация большой модели считается по сумме «вход + выход», а материалы романа на входе часто занимают куда больше места, чем те несколько тысяч знаков, что Вы пишете. Вся библия мира, персонажи, интрига и архитектура книги вместе легко дают десятки тысяч токенов, и на каждую главу тратятся заново.
Многие экономят, глядя на «сколько знаков написал ИИ» — не туда. Главная доля — «сколько материалов ИИ каждый раз прочитал». Чем полнее материалы, тем меньше ИИ отклоняется, но тем выше стоимость каждой генерации — это весы, которые Вам нужно взвешивать самому.
Наблюдение на замерах: во внутренних тестах при переводе библии мира и персонажей с «Полностью» на «Только названия» токены контекста одного письма обычно заметно снижаются, а на качество письма обычных глав это почти не влияет. Ключ к экономии — различать, «какие материалы ИИ сейчас действительно нужны».
Чтобы понять общую структуру затрат ИИ-письма, посмотрите бесплатную и платную версии Maliang Writer.
Что такое «умная загрузка контекста»?
Умная загрузка контекста — когда переключатель «сколько материалов давать ИИ» отдан Вам, и объём задаётся по сценарию, а не «всё включено» без раздумий. Её антоним — «засовывание всего»: что бы ни писалось, все материалы книги отправляются разом.
Идея проста: при написании обычных глав ИИ достаточно знать, «какие есть персонажи и какие записи библии существуют», детали он запросит по необходимости; полные материалы нужны только для ключевых поворотов. Умная загрузка позволяет под разные сценарии давать ровно достаточный объём информации.
Особый взгляд: экономия токенов не означает «ИИ глупеет от нехватки материалов». Как раз наоборот: если дать слишком много, ключевое тонет, и ИИ не схватывает главное. Точная подача «по необходимости» и экономит, и часто пишет более сфокусированно.
Вход — в панели ИИ-помощника: нажмите шестерёнку «Управление функциями ИИ» и перейдите на вкладку «Контекст». Полное описание — в руководстве по сборке контекста.
Шаг 1. Сначала разберитесь с оценкой токенов в реальном времени
Предпосылка экономии — сначала «видеть» расходы. Maliang Writer ещё до отправки в реальном времени оценивает, сколько токенов потребует такая сборка. Не придётся жалеть о списанных кредитах.
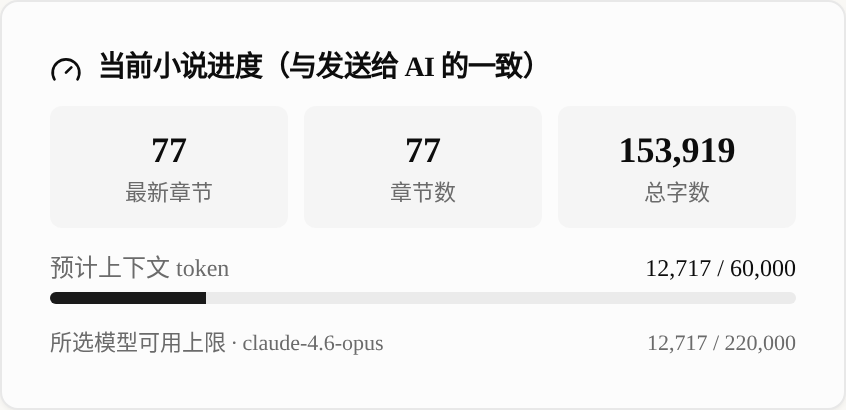
Вверху панели полоса «Ожидаемые токены контекста» и рядом верхний предел по умолчанию 60 000. Она в реальном времени считает расходы Вашей текущей сборки; покраснела — пора урезать. Ниже ещё строка «Доступный предел выбранной модели» с названием выбранной сейчас модели создания — у некоторых моделей окно небольшое, и здесь Вас заранее предупредят, что «эту сборку она не вместит».
Простая памятка: верхняя полоса сравнивает с «пределом платформы по умолчанию», нижняя строка — «вместит ли выбранная Вами модель». Если обе не красные — спокойно отправляйте.
Шаг 2. Замените «Полностью» на «Только названия»
Это самый быстрый по эффекту приём экономии токенов. Прокрутите до «Измерения сборки»: у библии мира, персонажей, интриги по два уровня — «Полностью» и «Только названия».
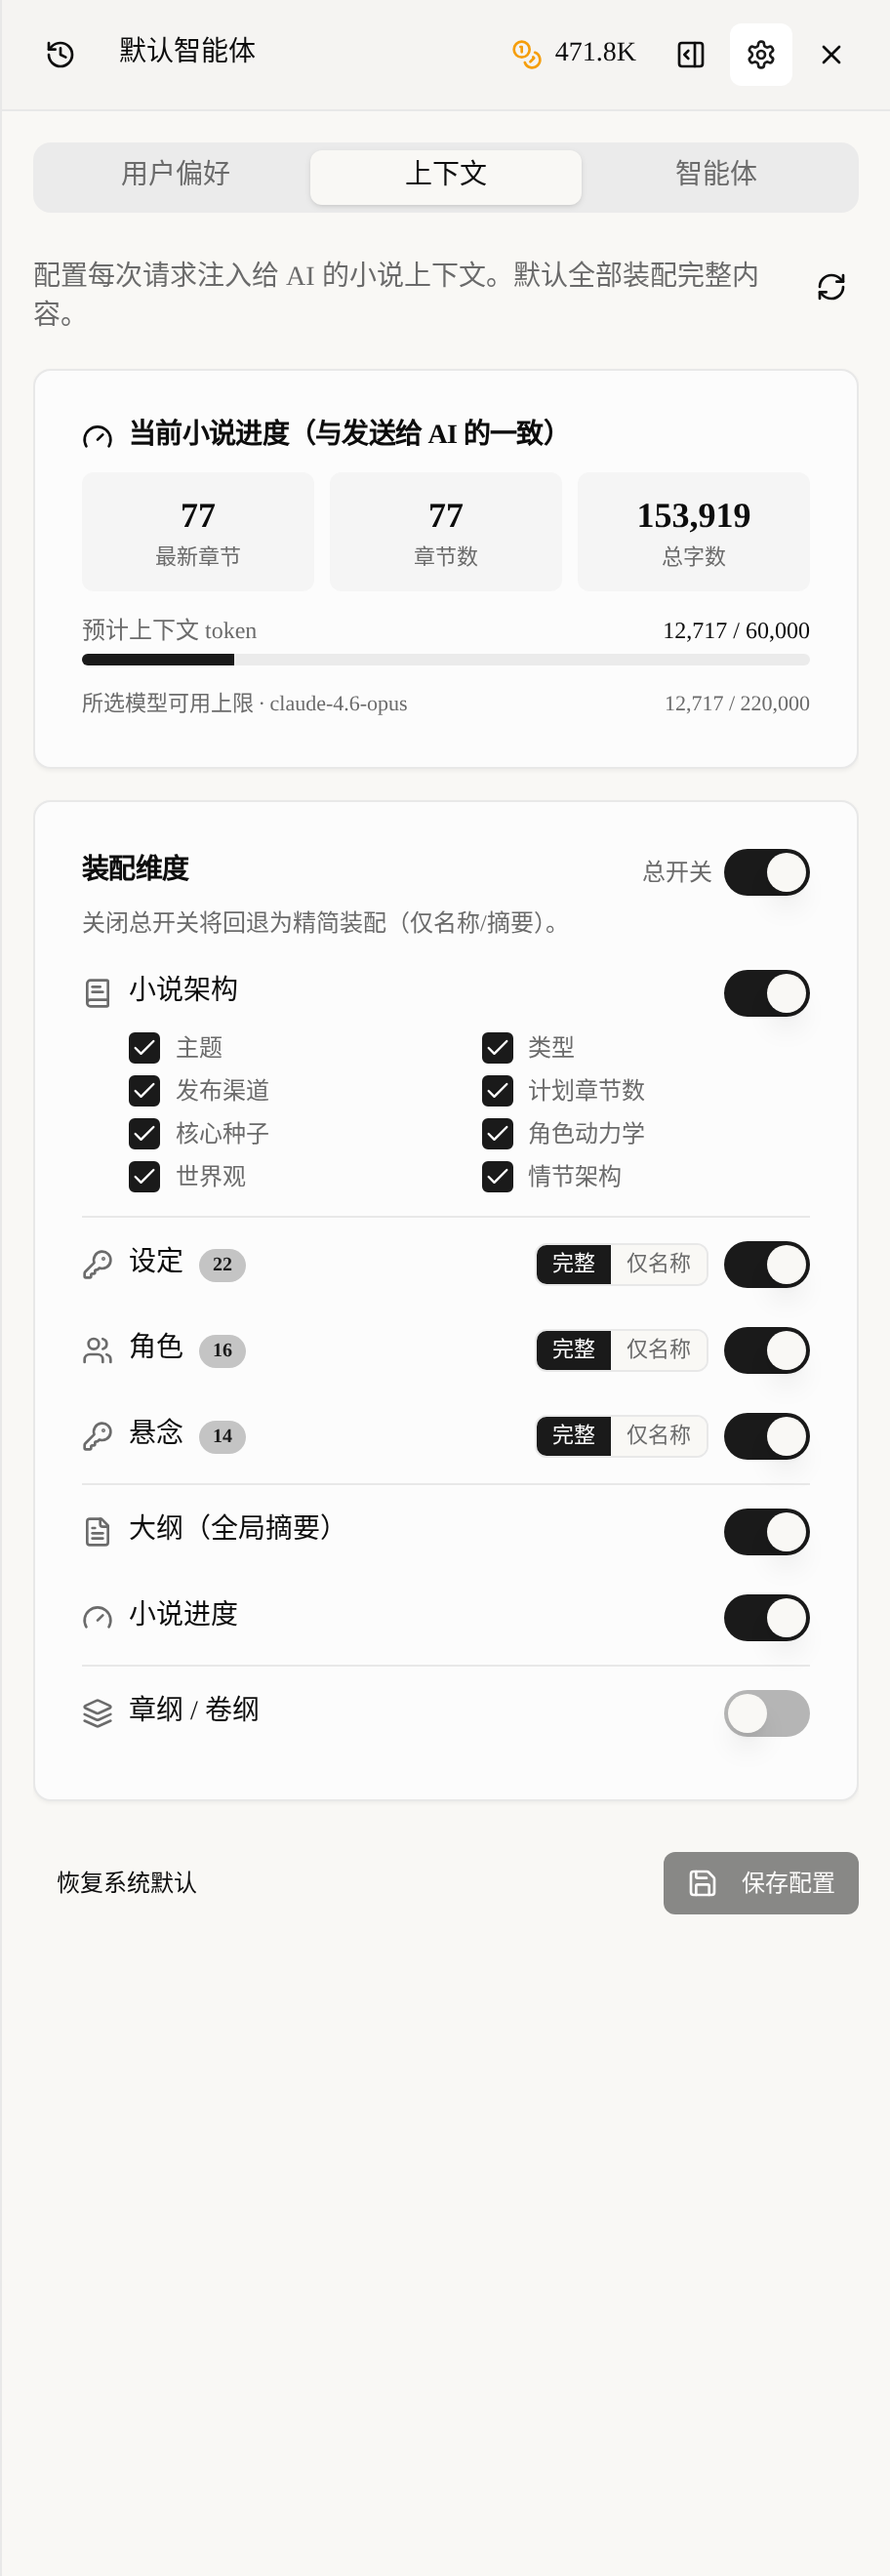
«Полностью» — ИИ получает запись целиком, «Только названия» — лишь список названий: ИИ знает, что «такие вещи существуют», но без деталей. При пакетном письме обычного текста с «Только названия» для библии мира и персонажей ИИ всё равно узнаёт героев и не отклоняется, а токенов экономится большой кусок.
Маленькие числа за каждым пунктом (например, «библия мира 22», «персонажи 16») — текущее число записей в этой книге, чтобы Вам было легче судить, «не слишком ли много, если вложить всё». В правом верхнем углу ещё «общий переключатель»: выключите его — вернётся самая экономная «сжатая сборка», что удобно для чистой болтовни об идеях.
Шаг 3. Планы глав и томов — по необходимости, а не всегда
Планы глав и томов — главные потребители токенов; по умолчанию они выключены, а включённые заставляют ИИ строго следовать плану, но расход заметно растёт. Поэтому они включаются «по необходимости», а не «всегда».
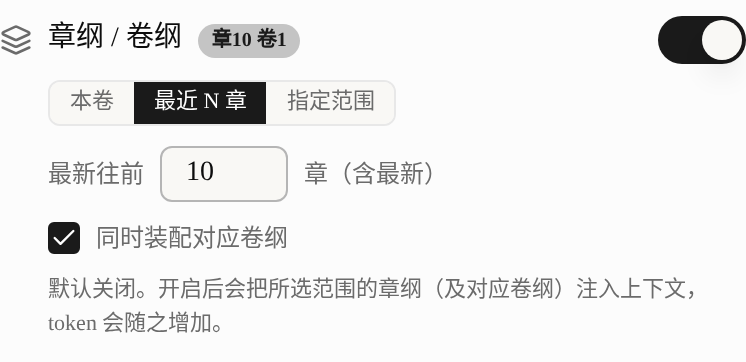
У них три диапазона сборки: «Текущий том» — только планы глав текущего тома, «Последние N глав» — N глав, считая от самой новой, «Указанный диапазон» — вручную задать интервал глав. Ниже есть флажок «Одновременно собирать соответствующие планы томов». Маленький значок у переключателя покажет, сколько планов глав и планов томов реально собрано в этот раз.
Напоминание об экономии: при обычном расширении текста и переходных главах планы глав и томов можно просто выключить; включайте только в ключевых главах, где «ИИ должен строго идти по плану», и в первую очередь выбирайте «Текущий том» или «Последние N глав», а не собирайте всю книгу по любому поводу.
Три практические пропорции экономии токенов
Не нужно каждый раз настраивать с нуля — применяйте по сценарию одну из трёх комбинаций. Вот три самые используемые ступени:
| Сценарий | Библия мира / персонажи | Интрига | Планы глав и томов | Подходит для |
|---|---|---|---|---|
| Пакетный текст (самый экономный) | Только названия | Выключена | Текущий том | Обычные главы, переходные главы |
| Ключевые главы (надёжно) | Полностью | Полностью | Последние N глав + план тома | Кульминации, повороты, развязки |
| Чистая болтовня об идеях (самый лёгкий) | Общий переключатель выключен | Выключена | Выключены | Мозговой штурм, диалог для вдохновения |
После изменений не забудьте нажать внизу «Сохранить конфигурацию» — настройка хранится отдельно для каждого романа: настроили для книги один раз — действует долго.
Личный вывод: большинство глав на деле «обычные», а ярких глав, которым нужно «Полностью», немного. Поставьте пропорцию по умолчанию на «самую экономную» и повышайте временно лишь при письме ключевых глав — за долгое время сэкономленные кредиты весьма заметны.
Что будет при превышении токенов? Защита от превышения
Если Ваша сборка выводит ожидаемые токены выше предела по умолчанию, система активно защищает, а не молча списывает деньги. Полоса краснеет и всплывает подсказка включить «Максимальный контекст» в настройках чата.
Если «Максимальный контекст» не включить, превышающая часть будет автоматически сжата, и ИИ может «увидеть не всё» — качество письма в этом случае снизится. Аналогично, если превышен «доступный предел выбранной модели», нижняя строка тоже покраснеет.
При покраснении два пути: либо сократить измерения по пропорции выше (самая экономная обычно сразу сбивает показатель), либо сменить модель на ту, у которой контекст больше. Как выбирать модель — в руководстве по выбору ИИ-модели.
Как ещё экономить? Два продвинутых приёма
Первый приём — снять нагрузку с контекста видимостью. Записи библии, которые временно не нужны, и заделы, до тома раскрытия которых ещё не дошли, поставьте в «Скрыть от ИИ» или «Постепенное открытие по томам» — и они не попадут в контекст. Даже если у Вас включено «библия полностью», реально соберётся лишь «часть, которую сейчас нужно дать»: экономия и защита от спойлеров. Подробнее — в постепенном раскрытии и видимости записей библии.
Второй приём — выбрать правильную модель. Для одной и той же задачи цена за единицу и окно контекста у разных моделей сильно различаются. Для обычных глав брать модель с хорошим соотношением цены и качества, а для ключевых глав переключаться на старшую — экономичнее.
Практическое напоминание: экономия токенов — это «комбинация ударов»: умная сборка уменьшает объём входа, видимость отсекает то, что давать не нужно, выбор модели оптимизирует цену за единицу. Три приёма вместе действеннее, чем сжатие любого одного. Включите это в свой каркас длинного романа, и стоимость длинного романа действительно станет управляемой.
Частые вопросы
В: Не ухудшит ли экономия токенов письмо ИИ?
Нет, если «давать по необходимости», а не «удалять как попало». Для обычных глав с «Только названия» ИИ достаточно знать, какие есть люди и записи библии, детали он вызовет по необходимости; «Полностью» нужно лишь для ключевых поворотов. Слишком много — тоже тонет главное, а точная подача часто пишет более сфокусированно.
В: Можно ли изменить предел по умолчанию 60 000 токенов? Обязательно ли включать «Максимальный контекст» при превышении?
60 000 — предел платформы по умолчанию. Если превысили и не включили «Максимальный контекст», превышающая часть автоматически сжимается и ИИ может видеть не всё; если включили — собирается по возможности в окно выбранной Вами модели. Рекомендуем сначала самой экономной пропорцией вернуть оценку в предел, а большой контекст включать лишь при настоящей необходимости.
В: Как узнать, сколько токенов на самом деле потрачено в этот раз?
Смотрите полосу «Ожидаемые токены контекста» вверху панели: она оценивает в реальном времени до отправки и сравнивает с пределом по умолчанию. Строка «Доступный предел выбранной модели» ниже сообщит, вместит ли текущая модель. Если обе не красные — спокойно отправляйте.
В: Нужно ли вообще включать планы глав и томов?
По необходимости. Они позволяют ИИ строго идти по плану, но потребляют много токенов. При обычном расширении и переходных главах просто выключайте; включайте лишь в ключевых главах и в первую очередь с «Текущим томом» или «Последними N главами», а не со всей книгой.
В: Настройка глобальная или отдельная для каждой книги?
Сохраняется отдельно для каждого романа. Пропорция экономии токенов, заданная для одной книги, действует только для неё, для другой нужно настраивать заново. После изменений не забудьте нажать «Сохранить конфигурацию», иначе в следующий раз снова будет сборка по умолчанию — целиком.
В заключение
Основная часть кредитов в ИИ-письме уходит на «чтение материалов», а сколько материалов читать — решаете Вы. Разберитесь в оценке токенов, замените «Полностью» на «Только названия», включайте планы глав и томов по необходимости — три шага заметно снизят расходы.
Добавьте разгрузку видимостью и выбор правильной модели, и экономия токенов станет многоразовой комбинацией. Прямо сейчас откройте руководство по сборке контекста и задайте пропорцию по умолчанию под свой темп письма, чтобы каждый кредит тратился там, где он действительно нужен.