Ahorra tokens con el ensamblado inteligente de contexto
¿Los créditos vuelan con poco texto? Por qué se disparan los tokens y un método de tres pasos para ahorrar, con tres proporciones listas para usar.
En este artículo 10 secciones
Solo le has pedido a la IA que continúe un fragmento de dos mil caracteres, y los créditos han bajado un buen trecho. El problema muchas veces no está en la «salida», sino en la «entrada»: antes de cada escritura, el sistema, por defecto, le mete a la IA toda la arquitectura, los ajustes, los personajes y el suspense del libro entero, y ese gasto de «leer material» es el verdadero culpable de que los tokens se disparen.
La buena noticia es que esa parte es totalmente controlable. La «carga inteligente de contexto» de Maliang Writer te deja decidir cuánto material le das a la IA cada vez. Este artículo, con un método de tres pasos, te enseña a gastar los créditos donde de verdad cuentan.
Puntos clave
- El disparo de tokens viene sobre todo del «lado de la entrada»: el ensamblado completo por defecto del material de la novela, y no la salida de la IA.
- Carga inteligente de contexto = «ensamblado a demanda» según el caso, en lugar de «meterlo todo» cada vez.
- Antes de enviar, Maliang Writer estima en tiempo real los tokens de este ensamblado y los compara con el límite predeterminado de 60 000; si se pone en rojo, avisa.
- Tres trucos para ahorrar tokens: pasar de «Completo» a «Solo nombre», activar a demanda los esquemas de capítulo y de volumen y desactivar las dimensiones que no se usan.
¿Por qué se disparan los tokens?
Porque la facturación de los modelos grandes se calcula sobre el total de «entrada + salida», y el material de la novela en el lado de la entrada suele ocupar mucho más que esas pocas miles de palabras que escribes. Todos los ajustes, personajes, suspense y arquitectura de un libro, sumados, fácilmente son decenas de miles de tokens, que se consumen de nuevo con cada capítulo.
Mucha gente intenta ahorrar fijándose en «cuántas palabras ha escrito la IA», y se equivoca de dirección. Lo que pesa de verdad es «cuánto material lee la IA cada vez». Cuanto más completo el material, menos se desvía la IA, pero más cuesta cada generación: es una balanza que tienes que ajustar tú.
Observación medida: en nuestras pruebas internas, al pasar los ajustes y los personajes de «Completo» a «Solo nombre», los tokens de contexto de una escritura suelen bajar de forma notable, casi sin efecto perceptible en la calidad de los capítulos cotidianos. La clave para ahorrar es distinguir «qué material puede usar de verdad la IA ahora».
Para entender la estructura de costes de la escritura con IA en conjunto, consulta Maliang Writer: versión gratuita vs de pago.
¿Qué es la «carga inteligente de contexto»?
La carga inteligente de contexto pone en tus manos el interruptor de «cuánto material se le da a la IA», para dar la cantidad adecuada según el caso en lugar de activarlo todo sin pensar cada vez. Su antónimo es «meterlo todo»: se envía de golpe el material de todo el libro, escriba lo que escriba.
La idea de fondo es muy simple: al escribir capítulos cotidianos, a la IA le basta con saber «qué personajes y qué ajustes existen», y los detalles los pedirá cuando los necesite; solo al escribir giros clave hace falta el material completo como respaldo. La carga inteligente consiste en darte la cantidad de información justa para cada caso.
Perspectiva exclusiva: ahorrar tokens no es «dar poco material y que la IA se vuelva tonta». Al contrario: si das demasiado, la información clave queda sepultada y la IA no capta lo importante. Dar «a demanda» con precisión ahorra dinero y a menudo escribe de forma más centrada.
La entrada está en la barra del asistente de IA: haz clic en el engranaje «Gestión de funciones de IA» y cambia a la pestaña «Contexto». Para la explicación completa, consulta el tutorial de ensamblado de contexto.
Paso 1: aprende a leer la estimación de tokens en tiempo real
La condición para ahorrar es poder «ver» el gasto. Maliang Writer estima en tiempo real, antes de enviar, cuántos tokens costará aproximadamente este ensamblado. No hace falta esperar a que descuenten los créditos para arrepentirse.
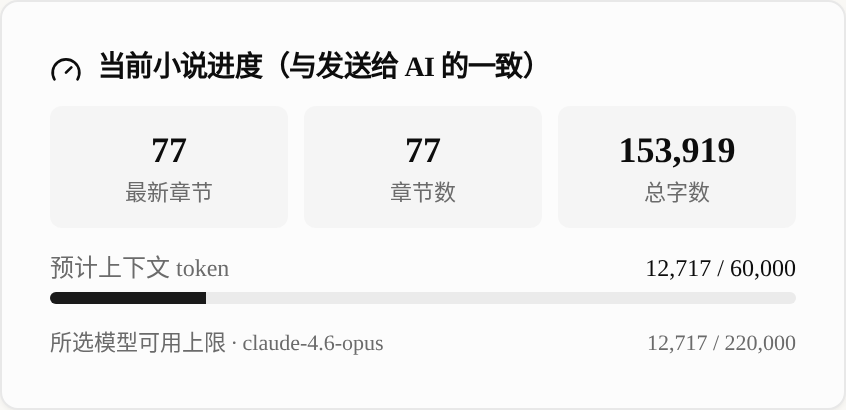
En la parte superior del panel hay una barra de progreso de «tokens de contexto estimados» seguida del límite predeterminado de 60 000. Cuenta en tiempo real el gasto del ensamblado actual y, si se pone en rojo, es que hay que simplificar. Más abajo hay otra línea, «Límite disponible del modelo seleccionado», con el nombre del modelo de generación que has elegido: algunos modelos tienen una ventana pequeña y aquí te avisan de antemano de que «este ensamblado no le cabe».
Una regla sencilla para recordarlo: la barra de arriba compara con el «límite predeterminado de la plataforma» y la línea de abajo compara con «si cabe en el modelo que has elegido». Si ninguna de las dos se pone en rojo, envía tranquilo.
Paso 2: cambiar «Completo» por «Solo nombre»
Este es el truco de efecto más inmediato para ahorrar tokens. Desplázate a «Dimensiones de ensamblado»: ajustes, personajes y suspense tienen cada uno dos niveles, «Completo» y «Solo nombre».
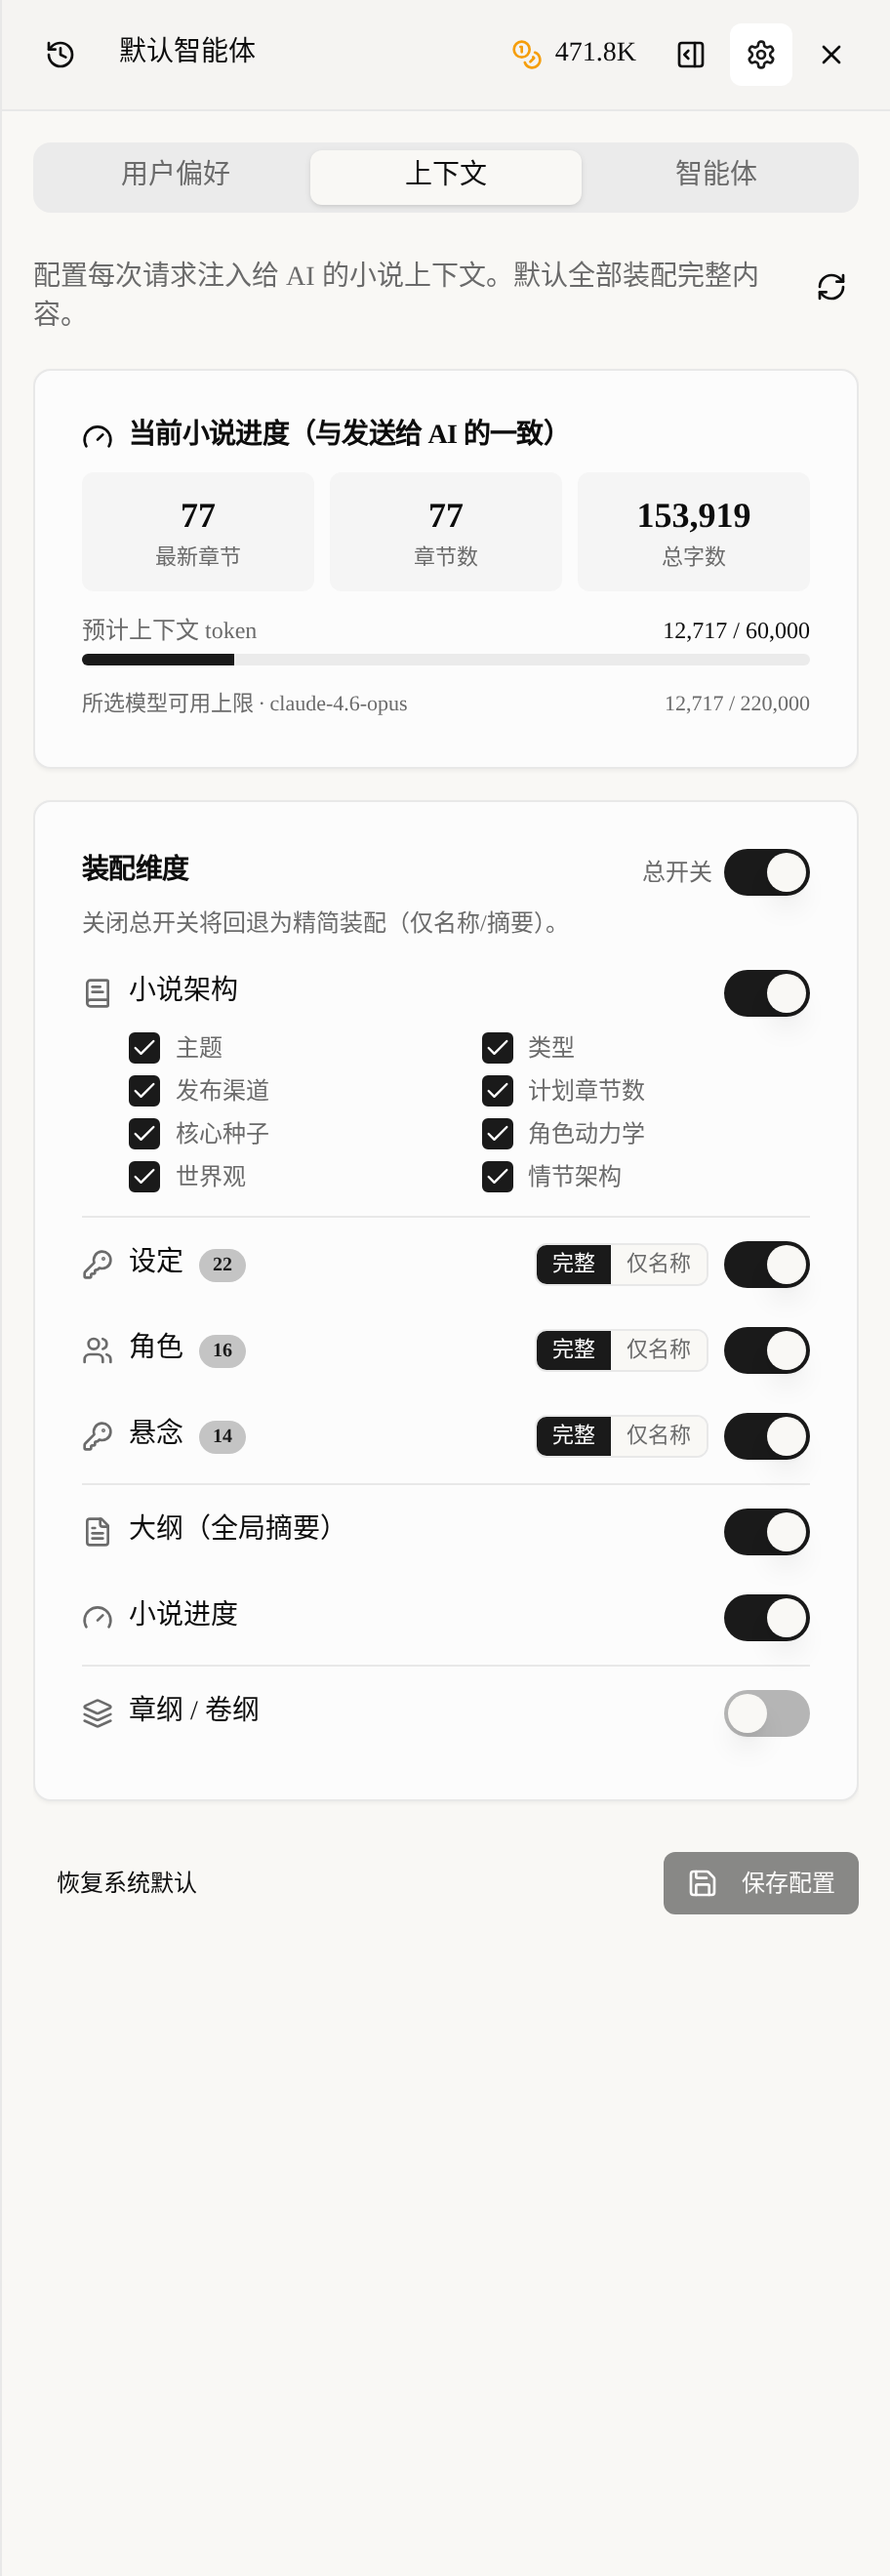
«Completo» da a la IA todo el material de cada elemento; «Solo nombre» solo da la lista de nombres, para que la IA sepa que «existen estas cosas» sin desplegar los detalles. Al escribir texto en lotes cotidianos, con ajustes y personajes en «Solo nombre» la IA sigue reconociendo a los personajes y sin desviarse, y los tokens se ahorran en buena parte.
El número pequeño tras cada elemento (por ejemplo, «Ajustes 22», «Personajes 16») es la cantidad actual de entradas de este libro, para ayudarte a juzgar si «meterlo todo sería demasiado». En la esquina superior derecha hay además un «interruptor general»: al apagarlo se vuelve al «ensamblado simplificado», el más económico, muy adecuado para charlar de ideas sin más.
Paso 3: esquemas de capítulo y de volumen a demanda, no ensamblarlos todos por defecto
Los esquemas de capítulo y de volumen son grandes consumidores de tokens: vienen desactivados por defecto, y al activarlos la IA sigue estrictamente el esquema, pero el gasto sube de forma notable. Por eso se activan «a demanda» y no «siempre».
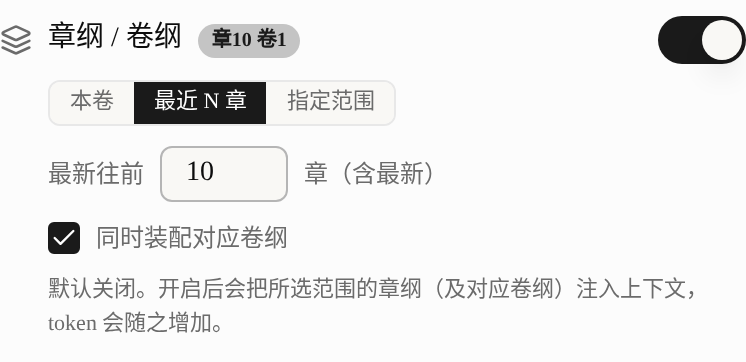
Tiene tres alcances de ensamblado: «Este volumen» solo da los esquemas de capítulo del volumen actual, «Últimos N capítulos» cuenta N capítulos hacia atrás desde el más reciente y «Rango personalizado» permite indicar a mano un intervalo de capítulos. Debajo hay además la casilla «Ensamblar también el esquema de volumen correspondiente». La pequeña insignia junto al interruptor te dice cuántos esquemas de capítulo y de volumen se han ensamblado en realidad esta vez.
Aviso para ahorrar: al ampliar texto o escribir capítulos de transición, puedes desactivar directamente los esquemas de capítulo y de volumen; actívalos solo en los capítulos clave en que quieras que la IA «siga estrictamente el esquema», y da prioridad a «Este volumen» o «Últimos N capítulos» en lugar de ensamblar todo el libro a las primeras de cambio.
Tres proporciones prácticas para ahorrar tokens
No hace falta ajustarlo todo desde cero cada vez: aplica estas tres combinaciones según el caso. Son los tres niveles que más usamos:
| Caso | Ajustes / personajes | Suspense | Esquemas de capítulo y de volumen | Adecuado para |
|---|---|---|---|---|
| Texto en grandes lotes (el más económico) | Solo nombre | Desactivado | Este volumen | Capítulos cotidianos, capítulos de transición |
| Capítulos clave (para ir seguro) | Completo | Completo | Últimos N capítulos + esquema de volumen | Clímax, giros, revelaciones |
| Charla de ideas (el más ligero) | Interruptor general apagado | Desactivado | Desactivado | Lluvia de ideas, inspiración en el diálogo |
Después de cambiar algo, no olvides hacer clic en «Guardar configuración» al pie: la configuración se guarda por novela, se fija una vez por libro y vale a largo plazo.
Experiencia exclusiva: la mayoría de los capítulos son en realidad «cotidianos», y los capítulos brillantes que de verdad necesitan «Completo» son pocos. Si fijas como proporción por defecto la «más económica» y la subes temporalmente solo al escribir capítulos clave, a la larga el ahorro de créditos es considerable.
¿Qué pasa si se supera el límite de tokens? El mecanismo de protección
Si tu ensamblado hace que los tokens estimados superen el límite predeterminado, el sistema te protege activamente en lugar de descontar el dinero en silencio. La barra de progreso se pone en rojo y aparece un aviso para que actives el «Contexto máximo» en la configuración del chat.
Si no activas el «Contexto máximo», la parte que excede se comprime automáticamente y la IA puede «no ver todo»: la calidad de lo escrito baja. Del mismo modo, si se supera el «límite disponible del modelo seleccionado», la línea de abajo también se pondrá en rojo.
Ante el rojo hay dos opciones: simplificar las dimensiones según las proporciones de arriba (con la más económica suele bajar de inmediato) o cambiar a un modelo con más contexto. Para elegir modelo, consulta la guía de selección de modelos de IA.
¿Qué más se puede hacer para ahorrar? Dos trucos avanzados
Primer truco: aligerar el contexto con la visibilidad. Pon en «Oculto a la IA» o en «Apertura progresiva por volúmenes» los ajustes que no uses a corto plazo y las pistas sembradas que aún no han llegado a su volumen de revelación, y no entrarán en el contexto. Así, aunque tengas activado «Ajustes completos», lo que se ensambla en realidad es solo «la parte que toca dar ahora»: ahorra y además evita destripes. Más detalles en Revelación progresiva y visibilidad de la biblia de la historia.
Segundo truco: elegir bien el modelo. Para la misma tarea, el precio unitario y la ventana de contexto varían mucho entre modelos. Usar un modelo de buena relación calidad-precio en los capítulos cotidianos y cambiar a uno de gama alta en los capítulos clave es una combinación más económica.
Aviso práctico: ahorrar tokens es una «combinación de golpes»: el ensamblado inteligente reduce el volumen de entrada, la visibilidad recorta los elementos que no hay que dar y la elección del modelo optimiza el precio unitario. Las tres juntas son más eficaces que comprimir cualquiera de ellas por separado. Si lo integras en tu marco de creación de novelas largas, el coste de la novela larga queda realmente bajo control.
Preguntas frecuentes
P: ¿Ahorrar tokens hará que la IA escriba peor?
No, siempre que sea «dar a demanda» y no «borrar a lo loco». En los capítulos cotidianos, con «Solo nombre» a la IA le basta saber qué personajes y ajustes hay, y los detalles se recuperan cuando hacen falta; solo para los giros clave se necesita «Completo». Dar demasiado sepulta lo importante, y dar la cantidad justa a menudo escribe de forma más centrada.
P: ¿Se puede cambiar el límite predeterminado de 60 000 tokens? Si se supera, ¿hay que activar sí o sí el «Contexto máximo»?
60 000 es el límite predeterminado de la plataforma. Si se supera y no activas el «Contexto máximo», la parte excedente se comprime automáticamente y la IA puede no verlo todo; si lo activas, se ensambla todo lo posible según la ventana del modelo elegido. Se recomienda primero bajar la estimación por debajo del límite con la proporción más económica y activarlo solo si de verdad necesitas un contexto grande.
P: ¿Cómo sé cuántos tokens he gastado esta vez?
Mira la barra de progreso de «tokens de contexto estimados» de la parte superior del panel: estima en tiempo real, antes de enviar, y lo compara con el límite predeterminado. La línea de debajo, «Límite disponible del modelo seleccionado», te dice si el modelo actual puede con ello. Si ninguna de las dos se pone en rojo, envía tranquilo.
P: ¿Hay que activar los esquemas de capítulo y de volumen?
A demanda. Permiten que la IA siga estrictamente el esquema, pero consumen muchos tokens. Al ampliar texto o escribir capítulos de transición, desactívalos directamente; actívalos solo en capítulos clave y da prioridad a «Este volumen» o «Últimos N capítulos», sin ensamblar todo el libro.
P: ¿La configuración es global o por libro?
Se guarda por novela. La proporción de ahorro de tokens que fijes para un libro solo afecta a ese libro, y al cambiar de libro hay que configurarla de nuevo. Después de cambiar algo, acuérdate de hacer clic en «Guardar configuración»; si no, la próxima vez volverás al ensamblado completo por defecto.
Para terminar
Los créditos de la escritura con IA se gastan sobre todo en «leer material», y cuánto material se lee lo decides tú. Entender la estimación de tokens, cambiar «Completo» por «Solo nombre» y activar a demanda los esquemas de capítulo y de volumen: con tres pasos se baja el coste un buen trecho.
Si además sumas el aligeramiento por visibilidad y la elección correcta del modelo, ahorrar tokens se convierte en una combinación reutilizable. Ve ahora mismo al tutorial de ensamblado de contexto y fija la proporción por defecto según tu ritmo de escritura, para que cada crédito se gaste donde de verdad hace falta.